
Nella letteratura sull'ottimizzazione il lavoro con la memoria non è al primo posto, e anche se arrivate a quei capitoli, con buona probabilità vi parleranno di throughput, di come far macinare al sistema diciamo cinque GB/s invece di tre. E in generale è la metrica giusta quando avete un'elaborazione in streaming o batch di dati tipo il baking dell'illuminazione, la generazione della navmesh o la compilazione degli shader. Lì conta quanti dati sono passati dal processore nel tempo a disposizione, e tutte le tecniche standard (SoA, array compatti, attraversamento lineare, vettorizzazione) lavorano per questa metrica.
In rari libri vedrete esempi in cui non conta «quanti» dati avete elaborato, ma quanto tempo è passato tra richiesta e risposta, e gli esempi classici del grande mondo riguardano il trading ad alta frequenza, i sistemi automotive e medicali, le comunicazioni audio e video: cose che al programmatore medio non sempre interessano, o che hanno una specificità lontana dall'ambito in cui potrebbe applicarle. Inoltre tutto questo è piuttosto lontano dallo sviluppo di giochi, perché la maggior parte delle tecniche di questi esempi e libri non si trasferisce così com'è, viste le peculiarità del gamedev. Nel verso opposto funziona altrettanto male, quindi ognuno vive con i suoi problemi, le sue idee e le sue stampelle.
Nei giochi, soprattutto strategici, simulatori e factory game, il compito in streaming di far passare dalla cache più dati possibile non è così pressante; in compenso saltano fuori vari compiti latency‑bound, che hanno bisogno che i loro dati, per quanto possibile, non vengano buttati fuori dalla cache e che, lavorando in gruppo, evitino il cache‑cannibalismo e le risse per il bus.
Vi ricordo che il budget del frame è sempre 16 ms, e in realtà anche meno, di un 10% circa, perché c'è la parte seriale del frame, lo swap dei buffer e un mucchio di compiti non parallelizzabili che qualcuno deve comunque fare, e di solito questo qualcuno siede alla fine del frame e fa tutto su un solo thread.
Per un visore VR saranno addirittura 10 ms, perché sotto i 100 fps iniziano a barcollare anche i più resistenti, e lì la sensazione di «scattino» si trasforma in «oddio, mi sa che vomito». Dentro questi 15(9) ms vivono logica di gioco, fisica, animazione, macchina di scripting, UI, preparazione dei comandi di rendering e il loro invio alla GPU, e tutti si spartiscono un'unica L3.
Libri, per chi volesse approfondire
Denis Bakhvalov, Performance Analysis and Tuning on Modern CPUs
Richard Fabian, Data‑Oriented Design
Fedor Pikus, The Art of Writing Efficient Programs
Anthony Williams, C++ Concurrency in Action
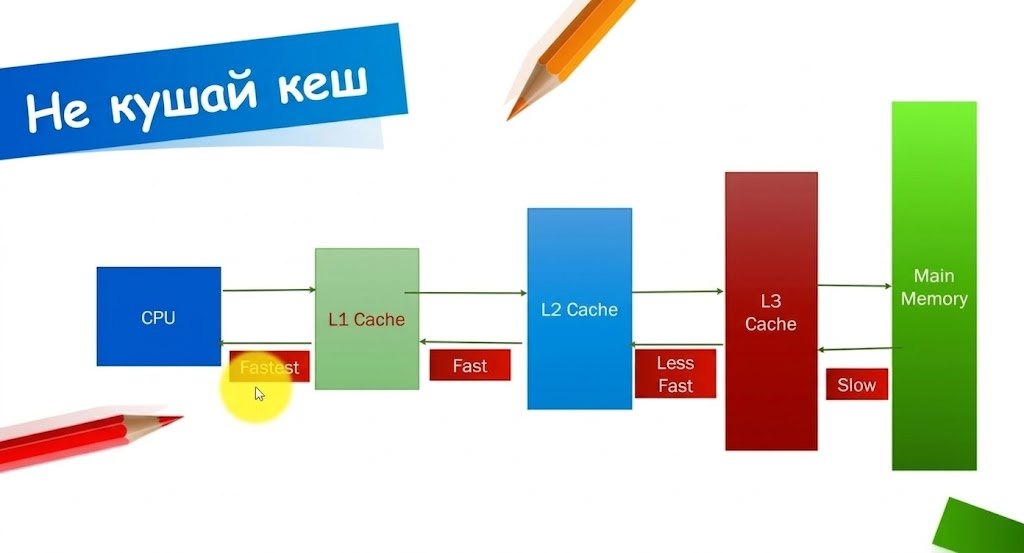
La maggior parte di voi conosce di sicuro il tempo di accesso a una cache line; se non ve lo ricordate: un accesso in L1 costa circa quattro cicli, in L2 già una decina, in L3 oltre quaranta, e andare in memoria principale su un desktop costa centinaia di cicli, durante i quali il processore semplicemente sta fermo (virtualmente, per il vostro task) e non fa nulla. Per il programmatore comune un nanosecondo o duecento non fanno grande differenza, perché vive nel mondo di unità e decine di millisecondi, finché non salta fuori che una qualche logica si fa il giro di mezzo livello chiedendo «amico, sei lontano da me? passami la tua posizione, che voglio calcolare la distanza da te». Salta fuori che la posizione sta nel suo pezzo di memoria, ogni giro è un miss, ed ecco che di questi nanosecondi se ne è accumulato un millisecondo e mezzo, mentre i dati sembrano stare in un array lineare e pure belli vicini.
E questo millisecondo e mezzo nel profiler non compare come riga a sé: vedete solo che la funzione viene chiamata molto spesso, e le chiamate sono spalmate su tutto il frame in uno strato uniforme; il codice in sé non sembra «molto lento», ma c'è puzza di bruciato. Il profiler mostra onestamente dove, ma non mostra perché.
Il problema principale del codice latency‑critical è che i dati che ci servono vengono sfrattati dalla cache perché vi si accede non abbastanza spesso, anche se vi si accede spesso. I primi due esempi saranno esplicativi e non legati a un gioco, mentre il codice degli esempi più avanti l'ho preso da un progetto reale, ma per non bruciare i nomi interni dei sistemi e la struttura dei dati gli esempi sono stati un po' riscritti senza nomi riconoscibili.
std::unordered_map<int32_t, SOrder> ActiveOrders;
while (Running)
{
    SCommand* pCommand = PollAiCommand();
    if (pCommand != nullptr)
    {
        auto Found = ActiveOrders.find(pCommand->OrderId);
        if (Found != ActiveOrders.end())
        {
            RespondToPlayer(pCommand->Origin, Found->second);
        }
    }
}
Finché non arriva una chiamata dalla logica, il ciclo non fa nulla di utile, e la hash table ActiveOrders se ne va dalla cache, perché nel frattempo nella stessa cache sono passate animazione, fisica, audio e streaming delle texture, e ognuno si è tirato dentro i propri dati. E quando finalmente il comando arriva, paghiamo in un colpo solo tutti i miss accumulati, e il giocatore vede un freeze o un calo di fps.
Lo stesso succede con qualsiasi struttura usata di rado ma che deve essere veloce, tipo la cache della localizzazione, l'albero dei widget UI del pannello che il giocatore apre, se va bene, una volta al minuto, la tabella «oggetto per identificatore». Sono tutte tecnicamente veloci, ma nel momento in cui servono i loro dati non sono in nessuna cache, e otteniamo un aumento del tempo di frame. Il problema è noto da tempo, e anche le soluzioni sono note da tempo, ma non sempre funzionano.
Riscaldamento software della cache
La soluzione più usata e più economica in termini di tempo, ma costosa in elettroni, è non lasciar uscire i nostri dati dalla cache. Sembra barbaro, funziona in modo altrettanto barbaro, e la prima reazione anche dei colleghi esperti di solito è «ma è una scemenza».
Per lavorare più velocemente bisogna fare accessi fittizi ai dati che vogliamo tenere in cache. Eccoci serviti: per leggere qualcosa in fretta bisogna leggere qualcosa? Non qualcosa a caso...
std::unordered_map<int32_t, SOrder> ActiveOrders;
int64_t WarmupSink = 0;
while (Running)
{
    if (HasPendingPlayerCommand())
    {
        SCommand* pCommand = PollPlayerCommand();
        if (pCommand != nullptr)
        {
            auto Found = ActiveOrders.find(pCommand->OrderId);
            if (Found != ActiveOrders.end())
            {
                RespondToPlayer(pCommand->Origin, Found->second);
            }
        }
    }
    else
    {
        const int32_t WarmupId = GetPlausibleOrderId();
        auto Found = ActiveOrders.find(WarmupId);
        WarmupSink += (Found != ActiveOrders.end()) ? 1 : 0;
    }
}
WarmupSink qui serve perché il compilatore non butti via tutto il riscaldamento come codice senza effetti collaterali, e nemmeno questo aiuta sempre: il clang moderno si crede così furbo che butta via il riscaldamento lo stesso, per cui tocca inventarsi stampelle tipo scrivere questo valore da qualche parte in un log o in un file, così che il compilatore non allunghi le sue zampette sporche sul codice «morto».
Scambiamo un po' di elettroni e di banda in cambio della prevedibilità del tempo di risposta. Per gli fps medi sarà ovviamente un male, perché ci siamo presi parte del tempo che poteva andare in qualcosa di utile, per esempio nell'attesa di uno spinlock, ma nei casi in cui il giocatore ritrova quella povera unità di cui si era dimenticato qualche secondo fa e ci clicca sopra col mouse, ci guadagniamo e ci liberiamo del freeze.
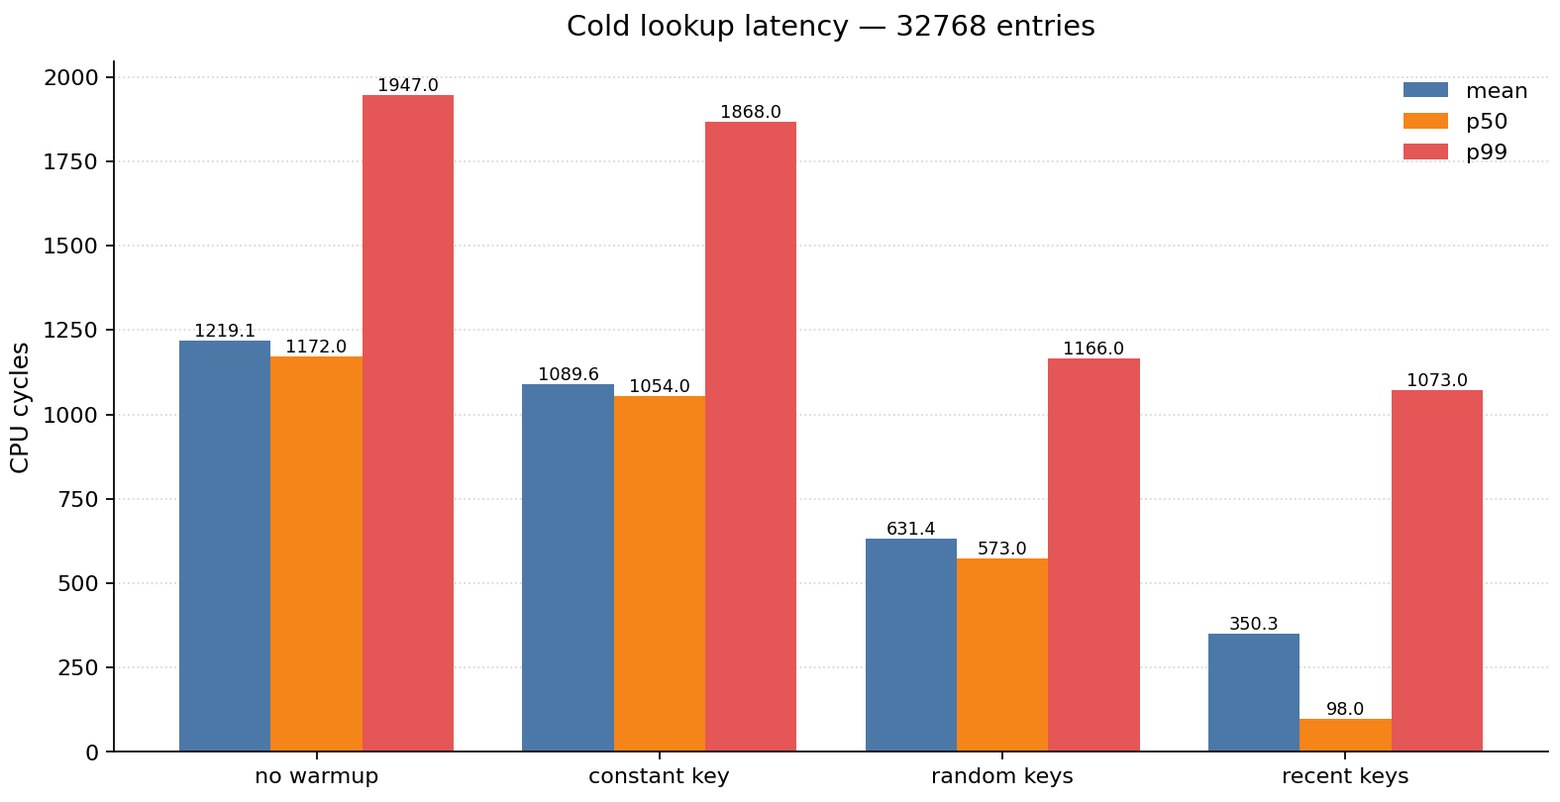
Meno è meglio, ovvero come leggere questo grafico. Nel grafico c'è lo stesso accesso find in una tabella da 32 768 voci dopo aver fatto passare apposta dati spazzatura nella cache: da sinistra a destra quattro modi di riscaldare la cache con i dati, in verticale i cicli del processore. Ogni strategia ha tre colonne: media, mediana (p50) e caso peggiore (p99).
Da sinistra a destra il riscaldamento diventa più furbo, e il tempo di ricerca cala. Senza riscaldamento la media è di circa 1220 cicli e il caso peggiore 1947, cioè i dati erano fuori dalla L3; con un'unica chiave costante è quasi uguale. Con chiavi casuali va circa due volte più veloce, e con le chiavi usate di recente otteniamo una riduzione multipla del tempo di ricerca.
Bisogna guardare le colonne arancioni e rosse (i tempi). Con il riscaldamento a chiavi recenti la mediana scende a 98 cicli, cioè la maggior parte degli accessi (p50) ha colpito le cache L1 o L2. Ed è comprensibile: stiamo tenendo a forza i dati in L1/L2, ma la media resta a 350 cicli (mean), perché una parte delle richieste (p90/p99, rare e impopolari) finisce comunque fuori dal working set e tira su la media.
Il p99 quasi non si distingue dal riscaldamento casuale, perché una richiesta rara va ugualmente male sia con i dati casuali sia con la cronologia: non cade nel working set in cache e si tira dietro i dati dalla memoria.
Codice del benchmark
#include <random>
#include <string>
#include <unordered_map>
#include <vector>

#include "perf_common.h"

namespace NColdLatency
{
	struct STooltipInputs
	{
		uint32_t Population;
		uint32_t OwnerId;
		uint32_t MarketIndex;
		uint32_t Development;
		uint32_t Reserved[ 4 ];
	};

	enum class EWarmup
	{
		None,
		Constant,
		Random,
		History
	};

	const char* GetWarmupName( EWarmup Mode )
	{
		switch ( Mode )
		{
			case EWarmup::None: return "no warmup";
			case EWarmup::Constant: return "constant key";
			case EWarmup::Random: return "random keys";
			case EWarmup::History: return "recent keys";
		}
		return "unknown";
	}

	class CRecentRing
	{
	public:
		static constexpr int32_t RING_SIZE = 64;

		void Push( uint32_t Id )
		{
			_Ring[ _Write ] = Id;
			_Write = ( _Write + 1 ) % RING_SIZE;
		}

		uint32_t Next()
		{
			_Read = ( _Read + 1 ) % RING_SIZE;
			return _Ring[ _Read ];
		}

	private:
		uint32_t _Ring[ RING_SIZE ] = {};
		int32_t _Write = 0;
		int32_t _Read = 0;
	};

	constexpr int32_t WARMUP_LOOKUPS = 64;
	constexpr int32_t WORKING_SET_SIZE = 64;
	constexpr int32_t WORKING_SET_HIT_PERCENT = 90;

	struct SResult
	{
		NPerf::SStats Cycles;
		uint64_t Sink = 0;
	};

	SResult RunExperiment( int32_t EntryCount, EWarmup Mode, int32_t SampleCount, size_t PollutionBytesPerSample )
	{
		std::mt19937 AccessRng( 777u );
		std::mt19937 WarmupRng( 12345u );
		std::mt19937 SetupRng( 20260801u );

		std::unordered_map<uint32_t, STooltipInputs> Table;
		Table.reserve( static_cast<size_t>( EntryCount ) * 2 );
		for ( int32_t Index = 0; Index < EntryCount; ++Index )
		{
			STooltipInputs Value = {};
			Value.Population = static_cast<uint32_t>( Index ) * 37u;
			Value.OwnerId = static_cast<uint32_t>( Index ) & 255u;
			Table.emplace( static_cast<uint32_t>( Index ), Value );
		}

		std::vector<uint32_t> WorkingSet( WORKING_SET_SIZE );
		for ( uint32_t& Id : WorkingSet )
		{
			Id = SetupRng() % static_cast<uint32_t>( EntryCount );
		}

		NPerf::CCachePolluter Polluter( PollutionBytesPerSample * 4, PollutionBytesPerSample );

		CRecentRing Recent;
		for ( uint32_t Id : WorkingSet )
		{
			Recent.Push( Id );
		}

		uint64_t Sink = 0;
		std::vector<double> Samples;
		Samples.reserve( SampleCount );

		for ( int32_t Sample = 0; Sample < SampleCount; ++Sample )
		{
			const bool FromWorkingSet = ( AccessRng() % 100u ) < static_cast<uint32_t>( WORKING_SET_HIT_PERCENT );
			const uint32_t CriticalId = FromWorkingSet
				? WorkingSet[ AccessRng() % WorkingSet.size() ]
				: ( AccessRng() % static_cast<uint32_t>( EntryCount ) );

			Polluter.Pollute();

			if ( Mode != EWarmup::None )
			{
				for ( int32_t Warm = 0; Warm < WARMUP_LOOKUPS; ++Warm )
				{
					uint32_t WarmId = 0;
					if ( Mode == EWarmup::Constant )
					{
						WarmId = 0;
					}
					else if ( Mode == EWarmup::Random )
					{
						WarmId = WarmupRng() % static_cast<uint32_t>( EntryCount );
					}
					else
					{
						WarmId = Recent.Next();
					}

					const auto Found = Table.find( WarmId );
					Sink += ( Found != Table.end() ) ? Found->second.Population : 0u;
				}
			}

			const uint64_t Start = NPerf::ReadTsc();
			const auto Found = Table.find( CriticalId );
			const uint32_t Payload = ( Found != Table.end() ) ? Found->second.Population : 0u;
			const uint64_t End = NPerf::ReadTsc();

			Sink += Payload;
			Samples.push_back( static_cast<double>( End - Start ) );
			Recent.Push( CriticalId );
		}

		SResult Result;
		Result.Cycles = NPerf::ComputeStats( std::move( Samples ) );
		Result.Sink = Sink + Polluter.GetSink();
		return Result;
	}
}

int main()
{
	NPerf::PinToFirstPerformanceCore();
	const double TscHz = NPerf::CalibrateTscHz();

	printf( "Cold-access latency of a rarely used lookup table\n" );
	printf( "================================================\n\n" );
	NPerf::PrintEnvironment( TscHz );

	const int32_t SampleCount = 2000;
	const size_t PollutionBytes = 40ull * 1024 * 1024;

	printf( "Samples per variant: %d\n", SampleCount );
	printf( "Cache pollution between accesses: %zu MB of writes\n", PollutionBytes / ( 1024 * 1024 ) );
	printf( "Warmup lookups per sample: %d\n", NColdLatency::WARMUP_LOOKUPS );
	printf( "Access pattern: %d%% inside a %d-entry working set, rest uniform\n\n",
		NColdLatency::WORKING_SET_HIT_PERCENT, NColdLatency::WORKING_SET_SIZE );

	const int32_t EntryCounts[] = { 1024, 8192, 32768, 131072 };
	const NColdLatency::EWarmup Modes[] = {
		NColdLatency::EWarmup::None,
		NColdLatency::EWarmup::Constant,
		NColdLatency::EWarmup::Random,
		NColdLatency::EWarmup::History
	};

	uint64_t TotalSink = 0;
	for ( int32_t EntryCount : EntryCounts )
	{
		printf( "--- table with %d entries -------------------------------------------------\n", EntryCount );
		printf( "%-14s %10s %10s %10s %10s %10s %10s\n", "warmup", "mean", "stddev", "p50", "p90", "p99", "max" );

		for ( NColdLatency::EWarmup Mode : Modes )
		{
			const NColdLatency::SResult Result =
				NColdLatency::RunExperiment( EntryCount, Mode, SampleCount, PollutionBytes );
			TotalSink += Result.Sink;

			printf( "%-14s %10.1f %10.1f %10.1f %10.1f %10.1f %10.1f\n",
				NColdLatency::GetWarmupName( Mode ),
				Result.Cycles.Mean,
				Result.Cycles.Stddev,
				Result.Cycles.P50,
				Result.Cycles.P90,
				Result.Cycles.P99,
				Result.Cycles.Max );
		}
		printf( "\n" );
	}

	printf( "(all values in CPU cycles; %.2f cycles = 1 ns on this machine)\n", TscHz / 1e9 );
	printf( "sink = %llu\n", static_cast<unsigned long long>( TotalSink ) );
	return 0;
}
Posti dove spararsi sui piedi
Il riscaldamento con valori casuali funziona solo se anche il carico reale è distribuito più o meno a caso sulla struttura, e nei giochi questo non succede quasi mai. I comandi del giocatore arrivano a raffiche, a volte sullo stesso oggetto: il giocatore tipico seleziona un'unità, ci clicca sopra sei volte, poi passa a un'altra, ci clicca sopra, e così via.
I pacchetti dal client arrivano a raffiche con gli stessi identificatori, e se in una situazione del genere scaldate la cache con chiavi casuali, vi trascinerete in cache dati completamente inutili e, sorpresa... sfratterete proprio quelli che stavano per essere usati, facendo non un vaccino ma, al contrario, peggiorando la malattia. Per questo bisogna scaldare non con dati casuali, ma con quello che è arrivato in passato, e in sostanza state scrivendo a mano un predittore che nel processore c'è già, solo che l'oracolo di silicio non sa che il giocatore ha selezionato la Borgogna o sta passando in rassegna i suoi eserciti; voi sì, e potete usare questa conoscenza.
Il secondo modo di spararsi su un piede è scaldare troppi dati: la cache è piccolissima rispetto ai working set e non basta per tutti. Tutto quello che ci trascinate dentro sfratterà qualcos'altro, e anche questo va tenuto a mente; quindi se i vostri set di dati superano 1 MB, dovete o ridurre il working set o rassegnarvi a tempi di esecuzione più lunghi con piccoli set di riscaldamento.
Il terzo modo per farsi male ai piedi è scaldare su un core diverso da quello dove poi gireranno i calcoli principali: non ha senso trascinare dati in una cache dove non servono, spero sia chiaro senza spiegazioni. In più va ricordato che scaldare la cache durante il lavoro vero è una pessima idea anche quella, perché verranno sfrattati i dati caldi usati di recente; il che, in totale, ci lascia non molti posti dove il riscaldamento funziona: thread separati a bassa priorità, frame saltati, o momenti in cui il giocatore esegue «azioni lunghe nel tempo e trascurabili nel costo», per esempio sta portando il cursore verso un pulsante ma non l'ha ancora premuto.
Continuiamo gli esperimenti con tabelle di dimensioni diverse, e tra un accesso e l'altro sfrattiamo la cache con quaranta megabyte di scritture: sulla macchina di test ho una L3 da 30 megabyte, quindi viene sfrattata in modo garantito e per intero. Poi lanciamo find e guardiamo cosa ne esce, cioè emuliamo una ricerca su cache fredda con riscaldamento preventivo. Il senso del test: emuliamo le azioni di un giocatore che ogni tanto clicca sulle unità, ma periodicamente facciamo girare una ricerca «a vuoto» con strategie diverse e ne buttiamo via i risultati, per tenere la cache tiepida di dati.
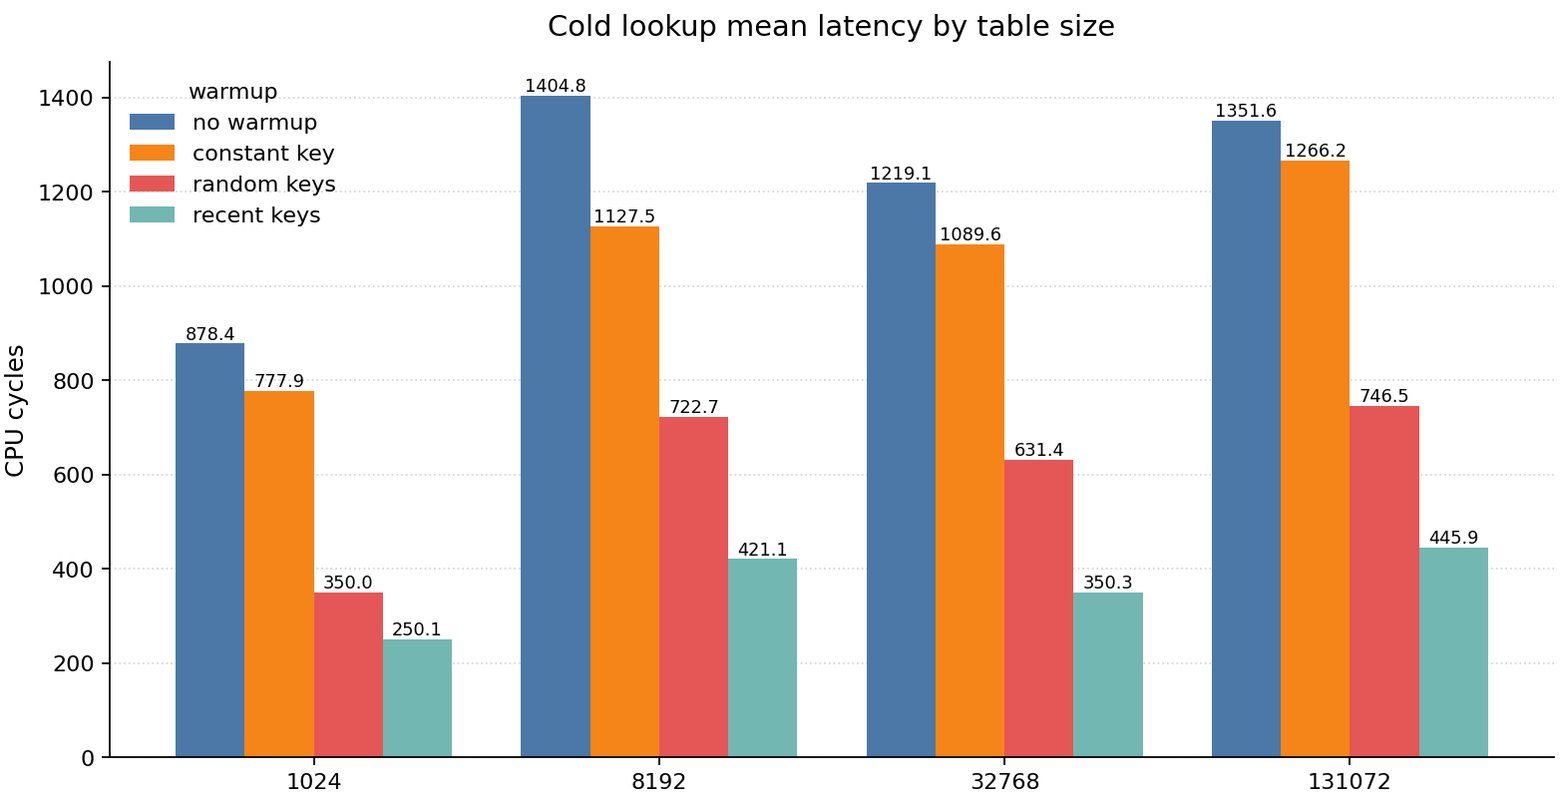
Come al solito meno è meglio, ed ecco come leggere questo grafico. La colonna senza riscaldamento sarà la nostra «misura peggiore ideale», cioè chiamiamo la ricerca nella tabella solo quando serve davvero, ma già il riscaldamento con una sola ultima chiave dà circa il dieci per cento, tenendo un po' in forma la «cache». Il guadagno è piccolo, certo, perché tenete in cache i dati di un solo ramo di ricerca tra i log2(size) possibili.
Poi diventa più interessante, e il riscaldamento con chiavi casuali dà già x2, il che si spiega con la natura casuale dei dati stessi: numeri casuali su un campionamento casuale nel benchmark si sposano bene, quindi il riscaldamento funziona.
Il riscaldamento con chiavi recenti dà già x3.5 sulla media e oltre x11 sulla mediana, il che significa che il working set finisce nelle cache L1 o L2, cioè i dati davvero necessari si trovavano nella cache più veloce. Entusiasti di questi risultati voliamo dal direttore tecnico e mergiamo il commit, ottenendo -1% sul tempo di esecuzione negli scenari reali; beh, almeno non è un più... ed è già qualcosa.
Non funzionerà
E adesso vi racconto perché tutto il testo precedente si è rivelato inutile in un progetto reale. Ecco come appare una struttura che è semplicemente cresciuta nel gioco:
struct SLocation
{
    uint32_t OwnerId;
    uint32_t ControllerId;
    float    Development;
    uint16_t Population;
    uint8_t  TerrainType;
    uint8_t  Flags;
    char     DisplayName[64];
    uint8_t  History[200];
    uint8_t  Buildings[96];
};
La dimensione di questa struttura è di 376 byte, la scansione delle regioni della mappa ne legge quattro campi, cioè dieci byte, ma è costretta a trascinarsi in cache tutti e 376, il che ci porta a un carico utile in cache di circa (10 / 376) il tre per cento. Tutti quegli x2, x5, x10 della parte precedente li moltiplichiamo per il 3% e otteniamo un guadagno di x1.06 nelle chiamate reali. Ed ecco invece cosa viene usato davvero nella ricerca:
struct SColorInputs
{
    uint32_t OwnerId;
    uint8_t  TerrainType;
    uint8_t  Flags;
    uint16_t Padding;
};
Ora prendiamo solo quegli otto byte che servono davvero nella ricerca, e in una cache line da 64 byte entrano otto location invece di un sesto di una.
Codice del benchmark
#include <map>
#include <memory>
#include <numeric>
#include <random>
#include <vector>

#include <benchmark/benchmark.h>

#include "map_world.h"
#include "perf_common.h"

namespace NRecolorBench
{
	using NMapWorld::ComputeColor;
	using NMapWorld::SColorInputs;
	using NMapWorld::SLocationFat;

	struct SWorld
	{
		std::vector<SLocationFat> Fat;
		std::vector<SColorInputs> Slim;
		std::vector<uint32_t> SoaOwner;
		std::vector<uint8_t> SoaTerrain;
		std::vector<uint8_t> SoaFlags;
		std::vector<uint32_t> Palette;
		std::vector<uint32_t> ColorBuffer;
		std::vector<uint32_t> ShuffledIndices;
		std::vector<uint32_t> OrderedIndices;
		std::vector<std::unique_ptr<SColorInputs>> SlotStorage;
		std::vector<SColorInputs*> SlotPointers;
		std::vector<int32_t> HandleToSlot;
		std::vector<uint32_t> ShuffledHandles;
	};

	constexpr int32_t MAX_FAT_COUNT = 262144;

	SWorld* BuildWorld( int32_t Count, bool WithFat, bool WithScatteredSlots )
	{
		SWorld* pWorld = new SWorld();
		std::mt19937 Rng( 20260801u );

		if ( WithFat )
		{
			pWorld->Fat.resize( Count );
		}
		pWorld->Slim.resize( Count );
		pWorld->SoaOwner.resize( Count );
		pWorld->SoaTerrain.resize( Count );
		pWorld->SoaFlags.resize( Count );
		pWorld->ColorBuffer.resize( Count );

		pWorld->Palette.resize( 256 );
		for ( int32_t Index = 0; Index < 256; ++Index )
		{
			pWorld->Palette[ Index ] = Rng();
		}

		for ( int32_t Index = 0; Index < Count; ++Index )
		{
			const uint32_t Owner = Rng() & 255u;
			const uint8_t Terrain = static_cast<uint8_t>( Rng() & 15u );
			const uint8_t Flags = static_cast<uint8_t>( Rng() & 7u );

			if ( WithFat )
			{
				SLocationFat& Location = pWorld->Fat[ Index ];
				Location.OwnerId = Owner;
				Location.ControllerId = Owner;
				Location.Development = 1.0f;
				Location.Population = static_cast<uint16_t>( Index & 0xFFFF );
				Location.TerrainType = Terrain;
				Location.Flags = Flags;
				Location.DisplayName[ 0 ] = 'L';
				Location.History[ 0 ] = 1;
				Location.Buildings[ 0 ] = 1;
			}

			pWorld->Slim[ Index ].OwnerId = Owner;
			pWorld->Slim[ Index ].TerrainType = Terrain;
			pWorld->Slim[ Index ].Flags = Flags;
			pWorld->Slim[ Index ].Padding = 0;

			pWorld->SoaOwner[ Index ] = Owner;
			pWorld->SoaTerrain[ Index ] = Terrain;
			pWorld->SoaFlags[ Index ] = Flags;
		}

		pWorld->OrderedIndices.resize( Count );
		std::iota( pWorld->OrderedIndices.begin(), pWorld->OrderedIndices.end(), 0u );
		pWorld->ShuffledIndices = pWorld->OrderedIndices;
		std::shuffle( pWorld->ShuffledIndices.begin(), pWorld->ShuffledIndices.end(), Rng );

		if ( WithScatteredSlots )
		{
			pWorld->SlotStorage.reserve( Count );
			pWorld->SlotPointers.reserve( Count );
			pWorld->HandleToSlot.resize( Count );
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				auto Slot = std::make_unique<SColorInputs>( pWorld->Slim[ Index ] );
				pWorld->SlotPointers.push_back( Slot.get() );
				pWorld->SlotStorage.push_back( std::move( Slot ) );
				pWorld->HandleToSlot[ Index ] = Index;
			}
			pWorld->ShuffledHandles = pWorld->ShuffledIndices;
		}

		return pWorld;
	}

	SWorld& GetWorld( int32_t Count )
	{
		static std::map<int32_t, SWorld*> Cache;
		auto Found = Cache.find( Count );
		if ( Found == Cache.end() )
		{
			const bool HeavyExtras = Count <= MAX_FAT_COUNT;
			Found = Cache.emplace( Count, BuildWorld( Count, HeavyExtras, HeavyExtras ) ).first;
		}
		return *Found->second;
	}

	void Recolor_FatStruct( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const SLocationFat& Location = World.Fat[ Index ];
				World.ColorBuffer[ Index ] = ComputeColor( Location.OwnerId, Location.TerrainType, Location.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
		State.SetBytesProcessed( State.iterations() * Count * static_cast<int64_t>( sizeof( SLocationFat ) ) );
	}

	void Recolor_HotSlice( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const SColorInputs& Inputs = World.Slim[ Index ];
				World.ColorBuffer[ Index ] = ComputeColor( Inputs.OwnerId, Inputs.TerrainType, Inputs.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
		State.SetBytesProcessed( State.iterations() * Count * static_cast<int64_t>( sizeof( SColorInputs ) ) );
	}

	void Recolor_SoA( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();
		const uint32_t* pOwner = World.SoaOwner.data();
		const uint8_t* pTerrain = World.SoaTerrain.data();
		const uint8_t* pFlags = World.SoaFlags.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				World.ColorBuffer[ Index ] = ComputeColor( pOwner[ Index ], pTerrain[ Index ], pFlags[ Index ], pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void Traverse_IndexedOrdered( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const SColorInputs& Inputs = World.Slim[ World.OrderedIndices[ Index ] ];
				World.ColorBuffer[ Index ] = ComputeColor( Inputs.OwnerId, Inputs.TerrainType, Inputs.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void Traverse_IndexedShuffled( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const SColorInputs& Inputs = World.Slim[ World.ShuffledIndices[ Index ] ];
				World.ColorBuffer[ Index ] = ComputeColor( Inputs.OwnerId, Inputs.TerrainType, Inputs.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	template <int32_t Distance>
	void Traverse_IndexedShuffled_Prefetch( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				if ( Index + Distance < Count )
				{
					_mm_prefetch( reinterpret_cast<const char*>( &World.Slim[ World.ShuffledIndices[ Index + Distance ] ] ), _MM_HINT_T0 );
				}
				const SColorInputs& Inputs = World.Slim[ World.ShuffledIndices[ Index ] ];
				World.ColorBuffer[ Index ] = ComputeColor( Inputs.OwnerId, Inputs.TerrainType, Inputs.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	template <int32_t Distance>
	void Traverse_LinearPrefetch( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				if ( Index + Distance < Count )
				{
					_mm_prefetch( reinterpret_cast<const char*>( &World.Slim[ Index + Distance ] ), _MM_HINT_T0 );
				}
				const SColorInputs& Inputs = World.Slim[ Index ];
				World.ColorBuffer[ Index ] = ComputeColor( Inputs.OwnerId, Inputs.TerrainType, Inputs.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void Traverse_HandlesShuffled( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const uint32_t Handle = World.ShuffledHandles[ Index ];
				const int32_t Slot = World.HandleToSlot[ Handle ];
				if ( Slot < 0 )
				{
					continue;
				}
				const SColorInputs* pInputs = World.SlotPointers[ Slot ];
				World.ColorBuffer[ Index ] = ComputeColor( pInputs->OwnerId, pInputs->TerrainType, pInputs->Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void Traverse_HandlesOrdered( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const uint32_t Handle = World.OrderedIndices[ Index ];
				const int32_t Slot = World.HandleToSlot[ Handle ];
				if ( Slot < 0 )
				{
					continue;
				}
				const SColorInputs* pInputs = World.SlotPointers[ Slot ];
				World.ColorBuffer[ Index ] = ComputeColor( pInputs->OwnerId, pInputs->TerrainType, pInputs->Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	BENCHMARK( Recolor_FatStruct )->Arg( 4096 )->Arg( 32768 )->Arg( 262144 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Recolor_HotSlice )->Arg( 4096 )->Arg( 32768 )->Arg( 262144 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Recolor_SoA )->Arg( 4096 )->Arg( 32768 )->Arg( 262144 )->Unit( benchmark::kMicrosecond );

	constexpr int32_t L2_RESIDENT = 32768;
	constexpr int32_t RAM_RESIDENT = 4194304;

	BENCHMARK( Recolor_HotSlice )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Traverse_IndexedOrdered )->Arg( L2_RESIDENT )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Traverse_IndexedShuffled )->Arg( L2_RESIDENT )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK_TEMPLATE( Traverse_IndexedShuffled_Prefetch, 4 )->Arg( L2_RESIDENT )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK_TEMPLATE( Traverse_IndexedShuffled_Prefetch, 8 )->Arg( L2_RESIDENT )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK_TEMPLATE( Traverse_IndexedShuffled_Prefetch, 16 )->Arg( L2_RESIDENT )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK_TEMPLATE( Traverse_IndexedShuffled_Prefetch, 32 )->Arg( L2_RESIDENT )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK_TEMPLATE( Traverse_IndexedShuffled_Prefetch, 64 )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK_TEMPLATE( Traverse_IndexedShuffled_Prefetch, 128 )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK_TEMPLATE( Traverse_IndexedShuffled_Prefetch, 256 )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK_TEMPLATE( Traverse_LinearPrefetch, 8 )->Arg( L2_RESIDENT )->Arg( RAM_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Traverse_HandlesOrdered )->Arg( L2_RESIDENT )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Traverse_HandlesShuffled )->Arg( L2_RESIDENT )->Unit( benchmark::kMicrosecond );
}

int main( int argc, char** argv )
{
	NPerf::PinToFirstPerformanceCore();

	printf( "sizeof( SLocationFat ) = %zu bytes\n", sizeof( NRecolorBench::SLocationFat ) );
	printf( "sizeof( SColorInputs ) = %zu bytes\n\n", sizeof( NRecolorBench::SColorInputs ) );

	benchmark::Initialize( &argc, argv );
	if ( benchmark::ReportUnrecognizedArguments( argc, argv ) )
	{
		return 1;
	}
	benchmark::RunSpecifiedBenchmarks();
	benchmark::Shutdown();
	return 0;
}
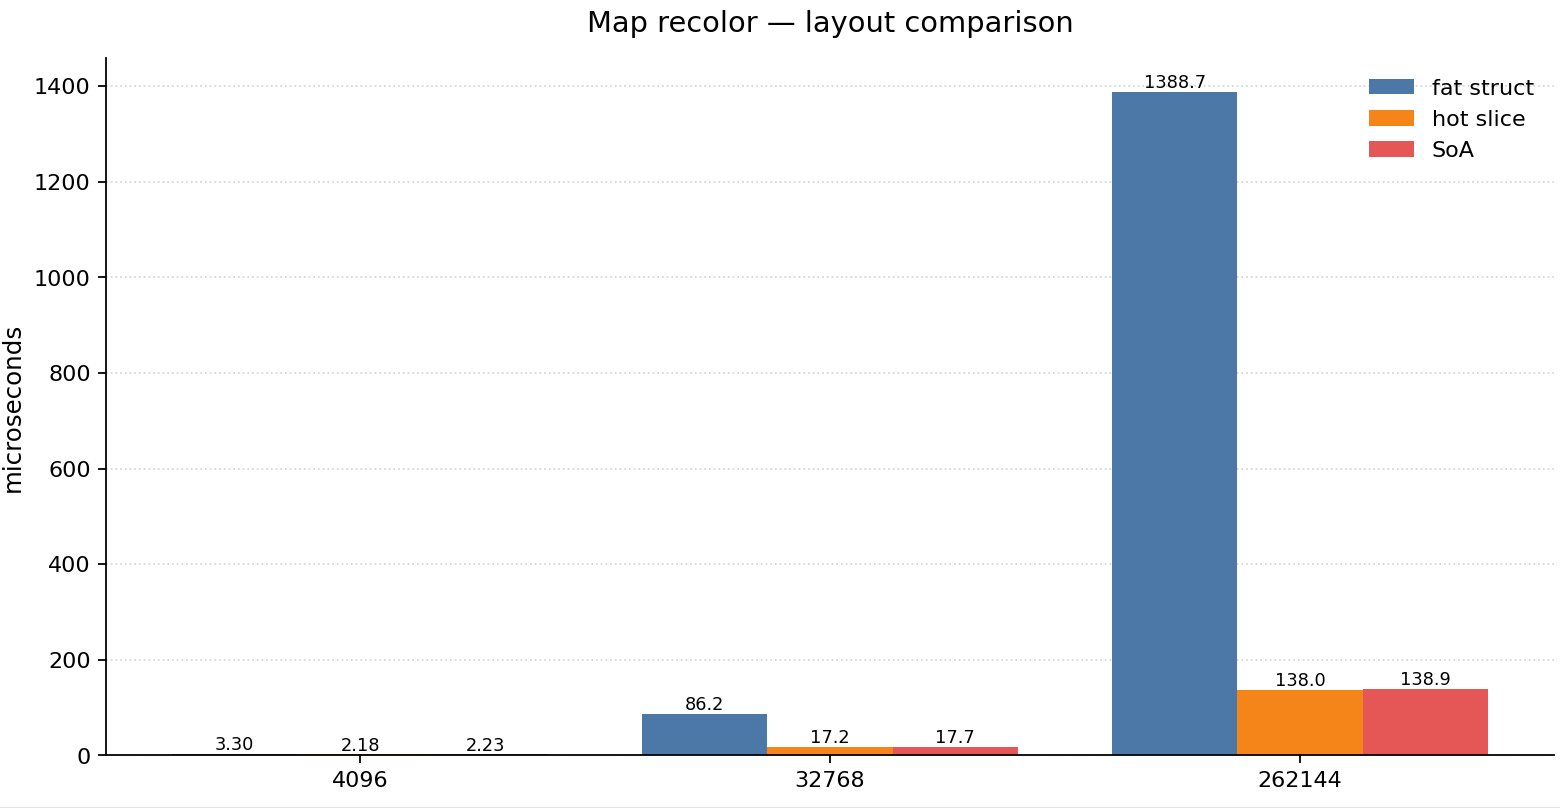
In entrambe le varianti la logica è la stessa, la differenza è solo nel layout delle strutture. Con 4096 location l'array di strutture grasse è un megabyte e mezzo, entra in L2, e il calo sarà di circa x1.35, cioè su una mappa piccola questo problema semplicemente non lo vedrete. Con 32 768 location/proprietà/sceglietevoi l'array grasso sarà già di 12 megabyte e uscirà dalla L2 finendo in L3, rendendo l'accesso x5 più caro, e con 262 144 sarà già di 98 megabyte e uscirà anche dalla L3, rendendo l'accesso 10 volte più caro.
Cioè lo stesso identico codice che sul prototipo con un numero ridotto di location/unità/proprietà funzionava bene, con la crescita dei contenuti degrada, e nel profiler vediamo che «il gioco ha iniziato a rallentare quando abbiamo aggiunto proprietà all'elaborazione», cioè diamo la colpa all'algoritmo di elaborazione, mentre in realtà bisogna sistemare la struttura. In sostanza è la stessa cosa che sparpagliare tutti i dati in array separati (ECS/SoA), dove ogni campo sta nel suo array.
void Recolor_SoA( benchmark::State& State )
{
	const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
	SWorld& World = GetWorld( Count );
	const uint32_t* pPalette = World.Palette.data();
	const uint32_t* pOwner = World.SoaOwner.data();
	const uint8_t* pTerrain = World.SoaTerrain.data();
	const uint8_t* pFlags = World.SoaFlags.data();
	for ( auto _ : State )
	{
		for ( int32_t Index = 0; Index < Count; ++Index )
		{
			World.ColorBuffer[ Index ] = ComputeColor( pOwner[ Index ], pTerrain[ Index ], pFlags[ Index ], pPalette );
		}
		benchmark::ClobberMemory();
	}
	State.SetItemsProcessed( State.iterations() * Count );
}
La variante SoA dà lo stesso risultato dell'estrazione dei «dati caldi» in una struttura separata (17.2 contro 17.4 microsecondi a 32768). Non c'è differenza perché leggiamo tutti e tre i campi, e distribuirli in array separati non ha senso; la conclusione è che nemmeno l'ECS è una pallottola d'argento: se avete estratto correttamente i dati caldi, la differenza diventa impercettibile, ma questo non vi costringe a trascinare un intero framework ECS nel gioco, né a trascinarlo dove non serve.
Indirezione costosa
Quanti articoli ci sono già stati su Habr sul costo dell'accesso tramite puntatore, eppure ogni engine che si rispetti continua a pestare questo rastrello con invidiabile costanza: si trova sempre un array di handle che si infila nella ricerca, la ricerca chiede al manager degli oggetti, il manager arriva attraverso un paio di puntatori all'oggetto stesso, che ovviamente vive nell'heap.
for (int32_t Index = 0; Index < Count; ++Index)
{
    const uint32_t Handle = _VisibleHandles[Index];
    const int32_t Slot = _HandleToSlot[Handle];
    if (Slot < 0)
    {
        continue;
    }
    const SColorInputs* pInputs = _SlotPointers[Slot];
    _ColorBuffer[Index] = ComputeColor(pInputs->OwnerId,
                                       pInputs->TerrainType,
                                       pInputs->Flags,
                                       pPalette);
}
Per chi ama frugare nel codice
#include <cstdio>

#include <benchmark/benchmark.h>

#include "map_bench_world.h"
#include "perf_common.h"

namespace NIndirection
{
	using NMapBenchWorld::ComputeColor;
	using NMapBenchWorld::GetWorld;
	using NMapBenchWorld::SColorInputs;
	using NMapBenchWorld::SWorld;

	void DenseLinear( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count, false, false );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const SColorInputs& Inputs = World.Slim[ Index ];
				World.ColorBuffer[ Index ] = ComputeColor( Inputs.OwnerId, Inputs.TerrainType, Inputs.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void IndexedOrdered( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count, false, false );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const SColorInputs& Inputs = World.Slim[ World.OrderedIndices[ Index ] ];
				World.ColorBuffer[ Index ] = ComputeColor( Inputs.OwnerId, Inputs.TerrainType, Inputs.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void IndexedShuffled( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count, false, true );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const SColorInputs& Inputs = World.Slim[ World.ShuffledIndices[ Index ] ];
				World.ColorBuffer[ Index ] = ComputeColor( Inputs.OwnerId, Inputs.TerrainType, Inputs.Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void HandlesOrdered( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count, false, true );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const uint32_t Handle = World.OrderedIndices[ Index ];
				const int32_t Slot = World.HandleToSlot[ Handle ];
				if ( Slot < 0 )
				{
					continue;
				}
				const SColorInputs* pInputs = World.SlotPointers[ Slot ];
				World.ColorBuffer[ Index ] = ComputeColor( pInputs->OwnerId, pInputs->TerrainType, pInputs->Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void HandlesShuffled( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SWorld& World = GetWorld( Count, false, true );
		const uint32_t* pPalette = World.Palette.data();

		for ( auto _ : State )
		{
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				const uint32_t Handle = World.ShuffledHandles[ Index ];
				const int32_t Slot = World.HandleToSlot[ Handle ];
				if ( Slot < 0 )
				{
					continue;
				}
				const SColorInputs* pInputs = World.SlotPointers[ Slot ];
				World.ColorBuffer[ Index ] = ComputeColor( pInputs->OwnerId, pInputs->TerrainType, pInputs->Flags, pPalette );
			}
			benchmark::ClobberMemory();
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	BENCHMARK( DenseLinear )->Arg( 32768 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( IndexedOrdered )->Arg( 32768 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( IndexedShuffled )->Arg( 32768 )->Arg( 4194304 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( HandlesOrdered )->Arg( 32768 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( HandlesShuffled )->Arg( 32768 )->Unit( benchmark::kMicrosecond );
}

int main( int argc, char** argv )
{
	NPerf::PinToFirstPerformanceCore();
	printf( "07_indirection\n\n" );

	benchmark::Initialize( &argc, argv );
	if ( benchmark::ReportUnrecognizedArguments( argc, argv ) )
	{
		return 1;
	}
	benchmark::RunSpecifiedBenchmarks();
	benchmark::Shutdown();
	return 0;
}
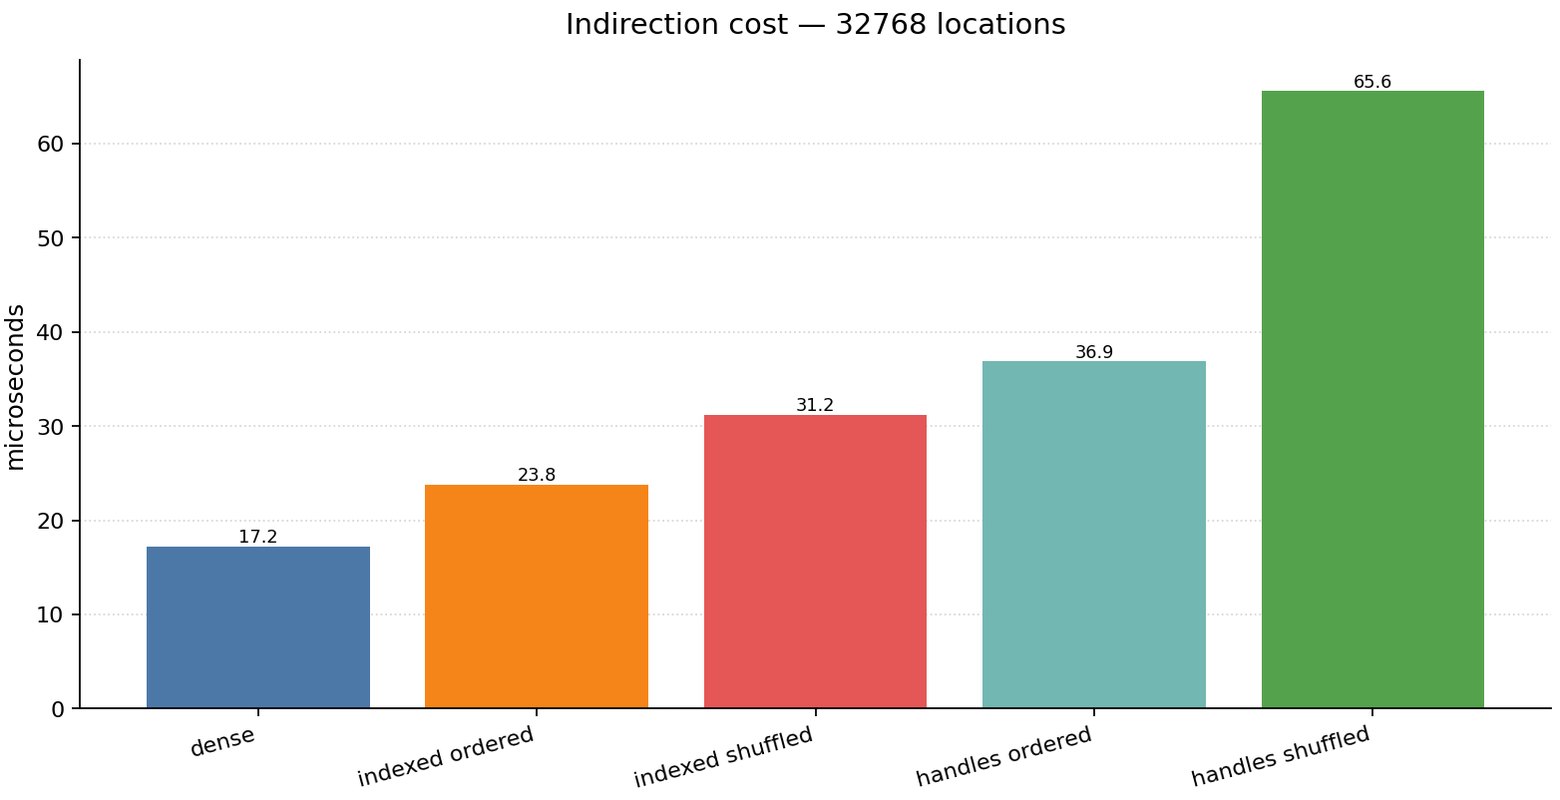
| come attraversiamo | tempo |
| --------------------------------- | ----- |
| array compatto in sequenza | 17.4 |
| via index buffer, in ordine | 22.9 |
| via index buffer, rimescolato | 29.8 |
| via handle e manager, in ordine | 40.4 |
| via handle e manager, rimescolato | 64.1 |Tra la prima e l'ultima riga la differenza è di 4 volte, e tutto il codice differisce solo per quante volte siamo saltati da un puntatore all'altro e in che ordine, per ottenere in uscita lo stesso identico risultato.
L'accesso tramite indice di per sé costa quasi il trenta per cento anche con un ordine di attraversamento ideale, l'ordine rimescolato aggiunge altrettanto, la doppia indirezione attraverso il manager e gli oggetti sparsi nell'heap aggiunge ancora di più, perché ogni oggetto è stato allocato con il suo new e sta dove ha trovato posto, non accanto ai vicini.
Su una mappa grande, con le condizioni aggiuntive, questo x4 diventa facilmente x5, x10, x20. È proprio questo il prezzo dell'accesso casuale, per cui ancora oggi tocca disporre i dati in sequenza.
Prefetch software
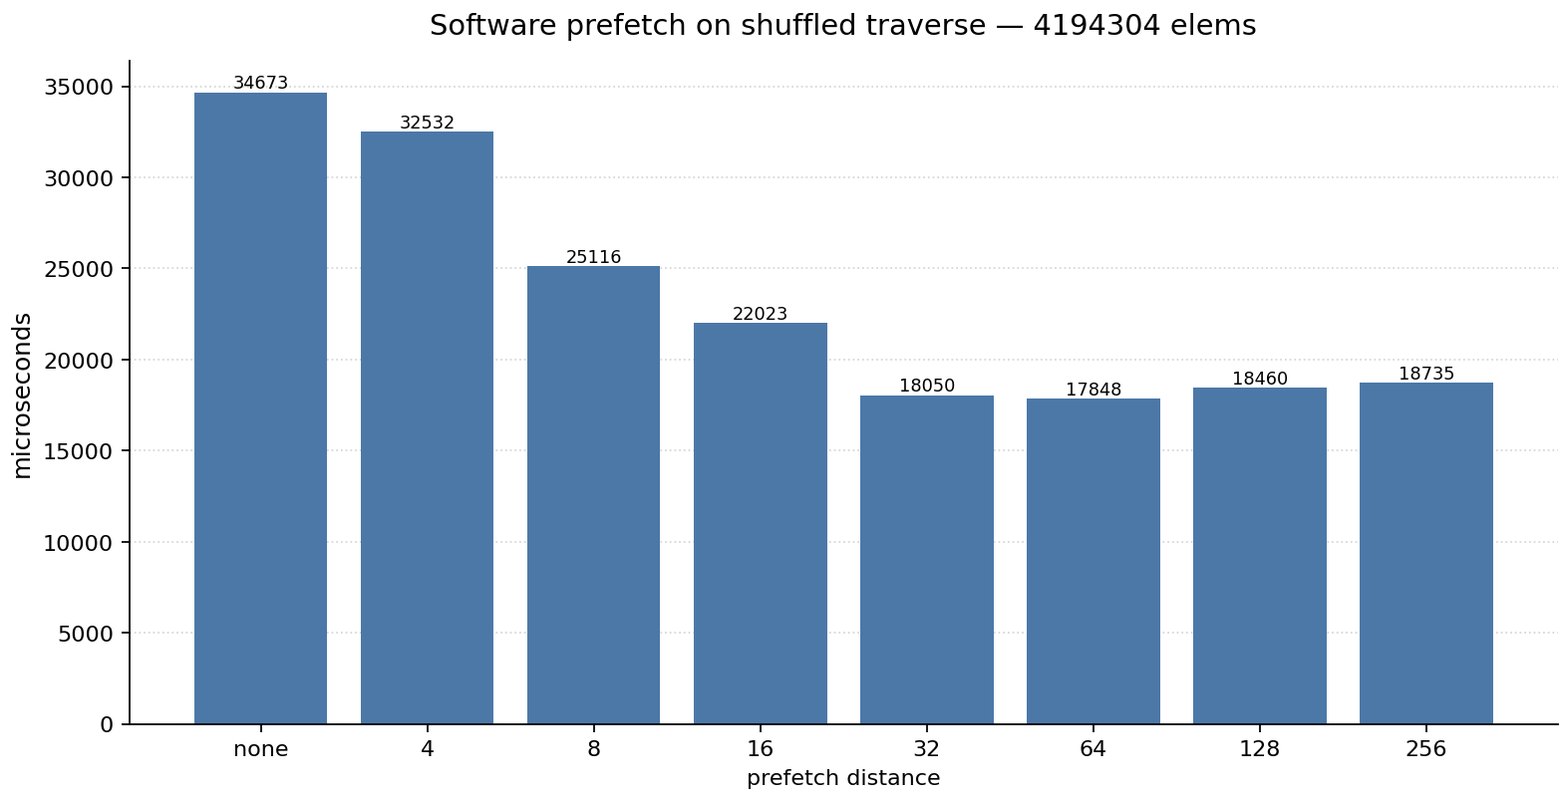
Forse avete sentito parlare dell'intrinsic_mm_prefetch, e che lo si usa quando il pattern di accesso ai dati è complesso e non viene rilevato dall'unità di predizione, e forse l'avete persino messo nel vostro codice chiedendovi perché non funzionasse... e a molti non funzionava, ma non perché non funzioni l'intrinsic in sé. Prendiamo lo stesso attraversamento rimescolato del paragrafo precedente: nel primo caso abbiamo un array da 256 kilobyte che sta tutto in L2, nel secondo è da 32 megabyte e non entra in L3.
template <int32_t Distance>
void Traverse(...)
{
    for (int32_t Index = 0; Index < Count; ++Index)
    {
        if (Index + Distance < Count)
        {
            _mm_prefetch(&_Data[_Indices[Index + Distance]], _MM_HINT_T0);
        }
        Process(_Data[_Indices[Index]]);
    }
}

| distanza       | 256 KB (in L2) | 32 MB (in memoria) |
| -------------- | -------------- | ------------------ |
| senza prefetch | 29.8           | 35 978             |
| 4              | 33.3           | 30 071             |
| 8              | 34.1           | 26 034             |
| 16             | 33.1           | 22 510             |
| 32             | 37.4           | 16 329             |
| 64             | -              | 18 163             |
| 128            | -              | 21 266             |
| 256            | -              | 19 256             |
Codice del benchmark
#include <algorithm>
#include <cstdint>
#include <cstdio>
#include <map>
#include <memory>
#include <random>
#include <unordered_map>
#include <vector>

#include <benchmark/benchmark.h>

#include "perf_common.h"

namespace NPolymorphism
{
	class IUnitBehavior
	{
	public:
		virtual ~IUnitBehavior() = default;
		virtual uint32_t Evaluate( uint32_t Input ) const = 0;
	};

	class CInfantry final : public IUnitBehavior
	{
	public:
		explicit CInfantry( uint32_t Strength ) : _Strength( Strength ) {}
		uint32_t Evaluate( uint32_t Input ) const override { return Input * 3u + _Strength; }

	private:
		uint32_t _Strength;
	};

	class CCavalry final : public IUnitBehavior
	{
	public:
		explicit CCavalry( uint32_t Strength ) : _Strength( Strength ) {}
		uint32_t Evaluate( uint32_t Input ) const override { return Input * 5u - _Strength; }

	private:
		uint32_t _Strength;
	};

	class CArtillery final : public IUnitBehavior
	{
	public:
		explicit CArtillery( uint32_t Strength ) : _Strength( Strength ) {}
		uint32_t Evaluate( uint32_t Input ) const override { return ( Input ^ _Strength ) * 7u; }

	private:
		uint32_t _Strength;
	};

	enum class EUnitType : uint8_t
	{
		Infantry,
		Cavalry,
		Artillery
	};

	struct SUnit
	{
		uint32_t Strength;
		EUnitType Type;
		uint8_t Padding[ 3 ];
	};

	inline uint32_t EvaluateByTag( const SUnit& Unit, uint32_t Input )
	{
		switch ( Unit.Type )
		{
			case EUnitType::Infantry: return Input * 3u + Unit.Strength;
			case EUnitType::Cavalry: return Input * 5u - Unit.Strength;
			case EUnitType::Artillery: return ( Input ^ Unit.Strength ) * 7u;
		}
		return 0u;
	}

	struct SArmy
	{
		std::vector<std::unique_ptr<IUnitBehavior>> Owned;
		std::vector<IUnitBehavior*> Scattered;
		std::vector<SUnit> Mixed;
		std::vector<SUnit> Grouped;
	};

	SArmy& GetArmy( int32_t Count )
	{
		static std::map<int32_t, SArmy*> Cache;
		auto Found = Cache.find( Count );
		if ( Found != Cache.end() )
		{
			return *Found->second;
		}

		SArmy* pArmy = new SArmy();
		std::mt19937 Rng( 20260801u );

		pArmy->Owned.reserve( Count );
		pArmy->Scattered.reserve( Count );
		pArmy->Mixed.reserve( Count );

		for ( int32_t Index = 0; Index < Count; ++Index )
		{
			const uint32_t Strength = Rng() & 0xFFFFu;
			const EUnitType Type = static_cast<EUnitType>( Rng() % 3u );

			std::unique_ptr<IUnitBehavior> Unit;
			switch ( Type )
			{
				case EUnitType::Infantry: Unit = std::make_unique<CInfantry>( Strength ); break;
				case EUnitType::Cavalry: Unit = std::make_unique<CCavalry>( Strength ); break;
				case EUnitType::Artillery: Unit = std::make_unique<CArtillery>( Strength ); break;
			}
			pArmy->Scattered.push_back( Unit.get() );
			pArmy->Owned.push_back( std::move( Unit ) );

			SUnit Tagged = {};
			Tagged.Strength = Strength;
			Tagged.Type = Type;
			pArmy->Mixed.push_back( Tagged );
		}

		std::shuffle( pArmy->Scattered.begin(), pArmy->Scattered.end(), Rng );

		pArmy->Grouped = pArmy->Mixed;
		std::stable_sort( pArmy->Grouped.begin(), pArmy->Grouped.end(),
			[]( const SUnit& Left, const SUnit& Right ) { return Left.Type < Right.Type; } );

		Cache.emplace( Count, pArmy );
		return *pArmy;
	}

	void Evaluate_VirtualScattered( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SArmy& Army = GetArmy( Count );
		for ( auto _ : State )
		{
			uint32_t Total = 0;
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				Total += Army.Scattered[ Index ]->Evaluate( static_cast<uint32_t>( Index ) );
			}
			benchmark::DoNotOptimize( Total );
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void Evaluate_TagMixed( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SArmy& Army = GetArmy( Count );
		for ( auto _ : State )
		{
			uint32_t Total = 0;
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				Total += EvaluateByTag( Army.Mixed[ Index ], static_cast<uint32_t>( Index ) );
			}
			benchmark::DoNotOptimize( Total );
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void Evaluate_TagGrouped( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SArmy& Army = GetArmy( Count );
		for ( auto _ : State )
		{
			uint32_t Total = 0;
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				Total += EvaluateByTag( Army.Grouped[ Index ], static_cast<uint32_t>( Index ) );
			}
			benchmark::DoNotOptimize( Total );
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	BENCHMARK( Evaluate_VirtualScattered )->Arg( 262144 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Evaluate_TagMixed )->Arg( 262144 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Evaluate_TagGrouped )->Arg( 262144 )->Unit( benchmark::kMicrosecond );
}

int main( int argc, char** argv )
{
	NPerf::PinToFirstPerformanceCore();
	printf( "08_virtual_vs_tag\n" );
	printf( "sizeof( SUnit ) = %zu\n\n", sizeof( NPolymorphism::SUnit ) );
	benchmark::Initialize( &argc, argv );
	if ( benchmark::ReportUnrecognizedArguments( argc, argv ) )
	{
		return 1;
	}
	benchmark::RunSpecifiedBenchmarks();
	benchmark::Shutdown();
	return 0;
}
Se il vostro array è piccolo, il prefetch dei dati non darà nulla nemmeno con un pattern complesso (guardate la colonna di sinistra), a nessuna distanza, e in certi punti ha persino peggiorato le cose, aggiungendo lavoro all'algoritmo. È un risultato atteso, perché i dati sono già in L2 e non c'è niente da spostare, mentre le istruzioni le avete aggiunte; e purtroppo è così che appare la maggior parte dei posti in cui la gente prova ad avvitare il povero prefetch.
Ma quando i dati sono davvero grandi, il working set è di megabyte e il pattern di accesso è complesso, il prefetch inizia a funzionare (guardate la seconda colonna, quella di destra); notate però la forma del guadagno: una distanza di 4 elementi è quasi inutile, perché i dati che avete messo in caricamento sono già lì vicino e la richiesta ripetuta viene scartata; con 8 e 16 va meglio, perché una parte dei dati viene tirata su in anticipo, e l'ottimo lo otteniamo a 32, perché nel momento in cui Process arriva agli elementi necessari, questi sono già in cache, e con il prefetch abbiamo davvero eliminato il collo di bottiglia, lasciando l'algoritmo lavorare senza attese.
E poi torna a peggiorare, perché abbiamo portato i dati in anticipo, ma sono di nuovo lontani dalla zona di lavoro e fanno in tempo a essere sfrattati prima che servano. Ecco perché __mm_prefetch viene usato male, e la mia statistica personale di fix di queste cose dice che nell'80% dei casi l'uso è sbagliato, cioè o non dava guadagno, o dava un guadagno negativo. Ma la fede del popolo nel potere del prefetch non si spegne, e gli permette di passare la code review con leggerezza.
E non credete a chi con una sola chiamata «prefetch» vi promette moltiplicatori nell'algoritmo. Un numero universalmente giusto per il prefetch non esiste: dipende dalla dimensione dell'elemento, da quanto lavoro si fa per iterazione, dal processore specifico, e sceglierlo a mano significa vendere a tutti i giocatori quello che funzionava da voi sulla vostra macchina. Se non sapete dire su quale processore funzionerà, quanto è grande il vostro array di lavoro e in quale livello di cache entrano i dati, un prefetch piazzato «tantopercosì» nel migliore dei casi vi lascerà con i vostri millisecondi.
La virtualità non è poi così cara
class IUnitBehavior
{
public:
    virtual ~IUnitBehavior() = default;
    virtual uint32_t Evaluate(uint32_t Input) const = 0;
};
Nel nostro engine c'è una classe così, che si può appendere a un'unità per modificarne un po' il comportamento; di questi «un po'» se ne possono appendere tanti a un singolo oggetto, e a un certo punto Evaluate è diventato visibile nel profiler. Tanti oggetti, tante proprietà, e a pesare era ormai semplicemente il numero di chiamate a Evaluate, così a un certo punto abbiamo dovuto rinunciare alla virtualità a favore di una soluzione più rozza.
struct SBeh
{
    uint32_t Strength;
    EBehType Type;
    uint8_t Padding[3];
};

inline uint32_t EvaluateByTag(const SBeh& Unit, uint32_t Input)
{
    switch (Unit.Type)
    {
        case EBehType::Move:  return Input * 3u + Unit.Strength;
        case EBehType::BuffRun:   return Input * 5u - Unit.Strength;
        case EBehType::BuffShoot: return (Input ^ Unit.Strength) * 7u;
    }
    return 0u;
}

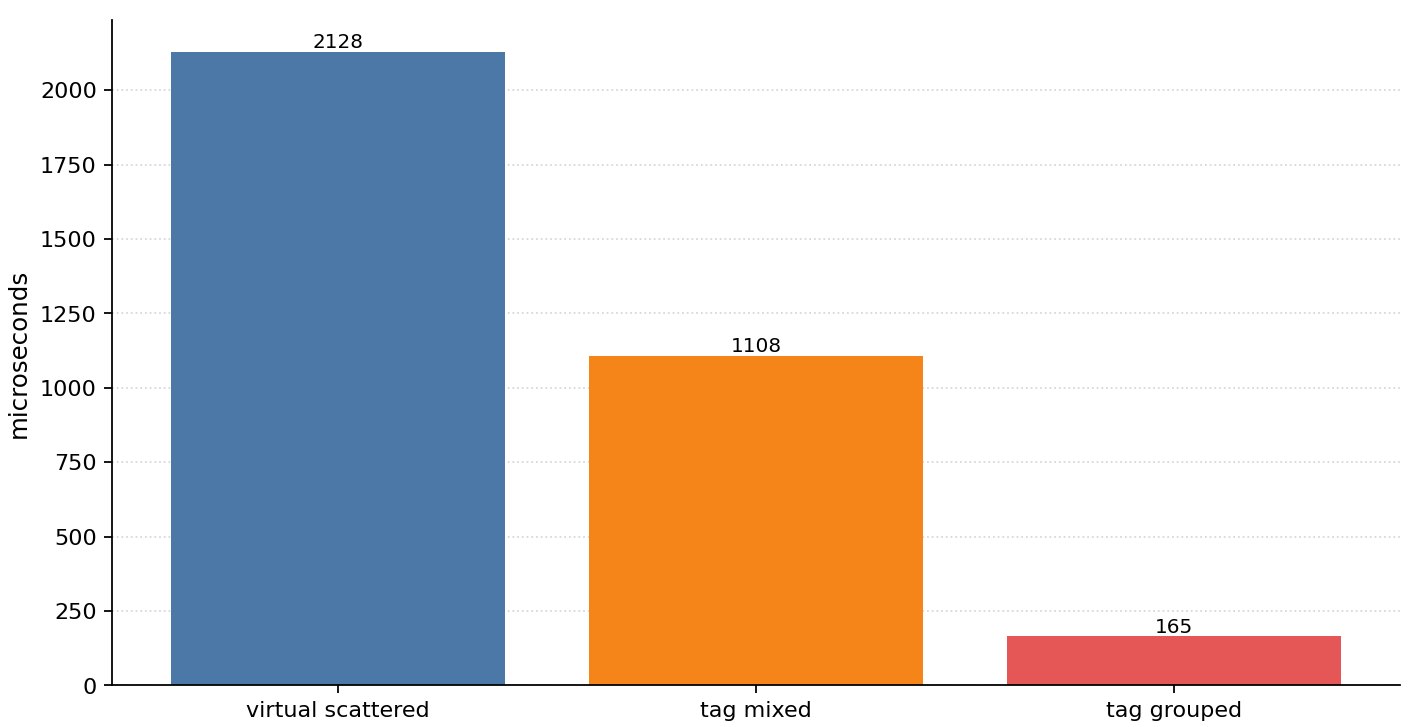
| come attraversiamo                          | tempo | rispetto al virtuale |
| ------------------------------------------- | ----- | -------------------- |
| chiamata virtuale, oggetti sparsi nell'heap | 1990  | 1.0                  |
| tag e switch, tipi mescolati                | 1078  | 1.8                  |
| tag e switch, ordinati per tipo             | 162   | 12.3                 |
sizeof(SBeh) è pari a otto byte, e le misure nel test le ho fatte su 262 144 «proprietà», poco meno di quanto una sessione accumula verso il late‑game. Ma togliere solo la virtualità e trasferirsi in un array compatto ha dato appena x2 sul tempo di chiamata, e la funzione continuava a stare appesa nel profiler, quindi abbiamo iniziato a guardare cos'altro desse fastidio. La chiamata virtuale era di nuovo una questione di indirezione, e sistemare l'accesso tramite puntatore rifacendolo con uno switch era una soluzione relativamente «saggia», ma sui processori moderni con grandi tabelle di salto dà un risultato debole, che in gran parte viene mangiato dalla logica di alto livello.
Il problema principale di performance questo non l'ha risolto, perché ha tolto solo un salto in memoria, ma gli oggetti sparsi per la memoria sono rimasti tali e quali. Ora invece dell'indirezione sulla chiamata virtuale abbiamo una marea di switch su tipi mescolati, avendo sostituito un salto imprevedibile in memoria con un branch imprevedibile.
Il branch predictor inizia a sbagliare tanto più spesso quanti più tipi avete, e ogni errore costa una decina abbondante di cicli. Visto questo, abbiamo fatto un altro piccolo passo e raggruppato i dati per tipo: ora il predittore indovina sempre, tranne qualche salto ai confini dei gruppi, e lo switch di fatto sparisce.
Qui non c'è una morale, ma se vi venisse voglia di sbattervi a riscrivere una gerarchia polimorfica in un array compatto, vi suggerisco di cercare un'altra soluzione: molto probabilmente il guadagno non sarà dove ve lo aspettate, e dove sarà toccherà cercarlo.
Bench, per chi ama frugare nel codice
#include <algorithm>
#include <cstdint>
#include <cstdio>
#include <map>
#include <memory>
#include <random>
#include <unordered_map>
#include <vector>

#include <benchmark/benchmark.h>

#include "perf_common.h"

namespace NPolymorphism
{
	class IBeh
	{
	public:
		virtual ~IBeh() = default;
		virtual uint32_t Evaluate( uint32_t Input ) const = 0;
	};

	class CMeleeBeh final : public IBeh
	{
	public:
		explicit CMeleeBeh( uint32_t Strength ) : _Strength( Strength ) {}
		uint32_t Evaluate( uint32_t Input ) const override { return Input * 3u + _Strength; }

	private:
		uint32_t _Strength;
	};

	class CChargeBeh final : public IBeh
	{
	public:
		explicit CChargeBeh( uint32_t Strength ) : _Strength( Strength ) {}
		uint32_t Evaluate( uint32_t Input ) const override { return Input * 5u - _Strength; }

	private:
		uint32_t _Strength;
	};

	class CBarrageBeh final : public IBeh
	{
	public:
		explicit CBarrageBeh( uint32_t Strength ) : _Strength( Strength ) {}
		uint32_t Evaluate( uint32_t Input ) const override { return ( Input ^ _Strength ) * 7u; }

	private:
		uint32_t _Strength;
	};

	enum class EBehType : uint8_t
	{
		Melee,
		Charge,
		Barrage
	};

	struct SBeh
	{
		uint32_t Strength;
		EBehType Type;
		uint8_t Padding[ 3 ];
	};

	inline uint32_t EvaluateByTag( const SBeh& Beh, uint32_t Input )
	{
		switch ( Beh.Type )
		{
			case EBehType::Melee: return Input * 3u + Beh.Strength;
			case EBehType::Charge: return Input * 5u - Beh.Strength;
			case EBehType::Barrage: return ( Input ^ Beh.Strength ) * 7u;
		}
		return 0u;
	}

	struct SBehSet
	{
		std::vector<std::unique_ptr<IBeh>> Owned;
		std::vector<IBeh*> Scattered;
		std::vector<SBeh> Mixed;
		std::vector<SBeh> Grouped;
	};

	SBehSet& GetBehSet( int32_t Count )
	{
		static std::map<int32_t, SBehSet*> Cache;
		auto Found = Cache.find( Count );
		if ( Found != Cache.end() )
		{
			return *Found->second;
		}

		SBehSet* pSet = new SBehSet();
		std::mt19937 Rng( 20260801u );

		pSet->Owned.reserve( Count );
		pSet->Scattered.reserve( Count );
		pSet->Mixed.reserve( Count );

		for ( int32_t Index = 0; Index < Count; ++Index )
		{
			const uint32_t Strength = Rng() & 0xFFFFu;
			const EBehType Type = static_cast<EBehType>( Rng() % 3u );

			std::unique_ptr<IBeh> Beh;
			switch ( Type )
			{
				case EBehType::Melee: Beh = std::make_unique<CMeleeBeh>( Strength ); break;
				case EBehType::Charge: Beh = std::make_unique<CChargeBeh>( Strength ); break;
				case EBehType::Barrage: Beh = std::make_unique<CBarrageBeh>( Strength ); break;
			}
			pSet->Scattered.push_back( Beh.get() );
			pSet->Owned.push_back( std::move( Beh ) );

			SBeh Tagged = {};
			Tagged.Strength = Strength;
			Tagged.Type = Type;
			pSet->Mixed.push_back( Tagged );
		}

		std::shuffle( pSet->Scattered.begin(), pSet->Scattered.end(), Rng );

		pSet->Grouped = pSet->Mixed;
		std::stable_sort( pSet->Grouped.begin(), pSet->Grouped.end(),
			[]( const SBeh& Left, const SBeh& Right ) { return Left.Type < Right.Type; } );

		Cache.emplace( Count, pSet );
		return *pSet;
	}

	void Evaluate_VirtualScattered( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SBehSet& Set = GetBehSet( Count );
		for ( auto _ : State )
		{
			uint32_t Total = 0;
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				Total += Set.Scattered[ Index ]->Evaluate( static_cast<uint32_t>( Index ) );
			}
			benchmark::DoNotOptimize( Total );
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void Evaluate_TagMixed( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SBehSet& Set = GetBehSet( Count );
		for ( auto _ : State )
		{
			uint32_t Total = 0;
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				Total += EvaluateByTag( Set.Mixed[ Index ], static_cast<uint32_t>( Index ) );
			}
			benchmark::DoNotOptimize( Total );
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	void Evaluate_TagGrouped( benchmark::State& State )
	{
		const int32_t Count = static_cast<int32_t>( State.range( 0 ) );
		SBehSet& Set = GetBehSet( Count );
		for ( auto _ : State )
		{
			uint32_t Total = 0;
			for ( int32_t Index = 0; Index < Count; ++Index )
			{
				Total += EvaluateByTag( Set.Grouped[ Index ], static_cast<uint32_t>( Index ) );
			}
			benchmark::DoNotOptimize( Total );
		}
		State.SetItemsProcessed( State.iterations() * Count );
	}

	BENCHMARK( Evaluate_VirtualScattered )->Arg( 262144 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Evaluate_TagMixed )->Arg( 262144 )->Unit( benchmark::kMicrosecond );
	BENCHMARK( Evaluate_TagGrouped )->Arg( 262144 )->Unit( benchmark::kMicrosecond );
}

int main( int argc, char** argv )
{
	NPerf::PinToFirstPerformanceCore();
	printf( "08_virtual_vs_tag\n" );
	printf( "sizeof( SBeh ) = %zu\n\n", sizeof( NPolymorphism::SBeh ) );
	benchmark::Initialize( &argc, argv );
	if ( benchmark::ReportUnrecognizedArguments( argc, argv ) )
	{
		return 1;
	}
	benchmark::RunSpecifiedBenchmarks();
	benchmark::Shutdown();
	return 0;
}
Non tutti i cali «da cache» sono colpa della cache
Dopo aver sistemato un po' il tempo di frame e tolto gli spike giornalieri, mi sono imbattuto nel tick settimanale sull'array degli edifici, dove ognuno ha un flag IsProducing e una proprietà Output, e sommiamo la produzione solo di quelli che stanno davvero lavorando, usando per questo il ciclo più stupido possibile.
for (int32_t Index = 0; Index < Count; ++Index)
{
    if (IsProducing[Index] != 0)
    {
        TotalOutput += Output[Index];
    }
}

| dati                               | tempo, µs  |
| flag mescolati                     | 93.9       |
| flag ordinati                      | 11.2       |
| flag mescolati, ma senza branch    | 16.1       |
Di cosa parla la tabellina qui sopra, e come si è ottenuto un guadagno di 8.4 volte tra la prima e la seconda riga. Con la cache questo non ha più il minimo rapporto, visto che gli array sono gli stessi e vengono letti linearmente. Tutta la differenza sta nel fatto che sui flag mescolati il branch predictor indovinerà la metà delle volte, e ogni errore costa dai dieci ai quindici cicli per lo svuotamento della pipeline.
E se prima ordinate i dati, vengono prima tutti quelli inattivi e poi tutti quelli che lavorano, e il predittore sbaglia una volta sola, sul confine. Come ottenere un array ordinato è un'altra questione, ma se all'update giornaliero avanza tempo nel frame, può ordinare questi array, e così all'inizio dell'update settimanale avremo un array pronto all'uso e il guadagno. Tenete anche conto che ordinare un array quasi ordinato costa molto meno che ordinarne uno disordinato, per cui conviene tenere questo array sempre nello stato giusto, spalmando il tempo di calcolo complessivo sui frame per ridurre il carico di picco.
Terza riga: togliamoif dal codice e lo sostituiamo con l'aritmetica, il che dà un guadagno paragonabile, ma la domanda sul perché non l'abbia fatto da solo il compilatore resta aperta. Il branch non c'è più, non c'è niente da predire, e il tempo scende quasi al livello dei dati ordinati, pur non avendo toccato l'ordine dei flag.
const uint64_t Mask = (uint64_t)(0u - (uint32_t)(IsProducing[Index] != 0));
TotalOutput += Output[Index] & Mask;
Perché tutto questo in un articolo sulla memoria? Perché x8 è più di quanto abbia dato una qualsiasi delle mie ottimizzazioni del layout dei dati, e se siete arrivati in un ciclo caldo con l'ipotesi «qui ci sono cache miss» e avete iniziato a reimpacchettare le strutture, mentre la vera causa è un if imprevedibile dentro il ciclo, perderete una giornata e otterrete zero. Quindi ragionare di cache miss si può, ma prima bisogna dimostrare che si tratta proprio di un cache miss e non di qualcos'altro, perché richiedono cure completamente diverse.
E mentre facevo questi esperimenti...
Non riguarda più direttamente le ottimizzazioni.
Per i benchmark ho scritto un inquinatore di cache che a ogni frame riscriveva gli stessi due megabyte, partendo dalla semplice supposizione che se si scrive in memoria, la cache viene sfrattata. Solo che la L3 su questa macchina è di 30 megabyte, i miei due megabyte sfrattavano esattamente due megabyte, e il grosso array da nove megabyte restava sempre in L3. E le prime esecuzioni hanno mostrato una differenza di 0.05 millisecondi tra cache fredda e calda, perché nell'esperimento un accesso freddo semplicemente non c'era.
Me ne sono accorto e ho alzato lo sfratto a 24 megabyte per frame, ed è andata ancora peggio: ora l'inquinatore stesso occupava 0.8 millisecondi e con il suo rumore copriva completamente quello che stavo misurando. Così ho iniziato ad aggiornare 2 megabyte di memoria fresca per frame, ma ogni volta in un punto nuovo di un grande buffer: in 30 frame si accumulano 60 megabyte di memoria diversa e la L3 viene “lavata via” per intero, mentre il carico per frame è molto piccolo, e questo si è avvicinato al quadro che vedevo nel progetto reale.
Il prefetch sull'array da 256 kilobyte avrebbe potuto non finire qui, perché 256 kilobyte stanno interamente in L2 e lì di miss non ce ne sono proprio, e stavo per buttare via l'idea come non funzionante. Ma poi qualcosa mi ha punzecchiato e ho provato il prefetch su 32 megabyte, e lì lo stesso identico codice ha dato x2. Nel progetto questa ottimizzazione comunque non è entrata, per i motivi detti prima.
Riscaldamento hardware
Oltre a strattonare i dati a mano, i processori su console e server sanno tenere in cache un pezzo di memoria a livello hardware. Con Intel (Cache Pseudo‑Locking) bisogna configurare una parte della cache per i dati critici, poi questa parte viene esposta all'esterno come dispositivo a caratteri e ci si lavora tramite mmap. AMD (L3 Cache Range Reservation) permette di riservare un intervallo di indirizzi fisici in L3; però nella documentazione utente dell'SDK la feature è menzionata solo a grandi linee, e come usarla tocca scoprirlo da soli.
Tutto questo funziona sulla L2 o sulla L3, ma non sulla L1, cioè nel livello più veloce non vi faranno comunque mettere le mani, e per tutto questo servono permessi e una macchina configurata, cosa che un gioco sul computer del giocatore non ha quasi mai; ma torna utile se scrivete un server dedicato che hostate voi stessi.
Su PS5 si possono bloccare fino a 256 kilobyte di L2 e «tenere i dati nella memoria veloce», ma di sorprese ce n'è a bizzeffe, perché non c'è nessuna politica di sfratto invisibile e dovete gestire tutto voi a mano. E in generale per i progetti console discutere di riscaldamento non ha senso, perché la cache è già piccola, e portargliene via una parte sarebbe un modo eccellente per spararsi sui piedi; per questo su console di solito si comincia riducendo le dimensioni delle strutture calde.
Il riscaldamento software della cache è una medicina, ma molto probabilmente non per i problemi che vedete nel vostro profiler, e ritrovarsi con cali strani e invisibili, che poi chissà come diavolo sono comparsi, è del tutto possibile.
P.S. Non incito nessuno a niente e non consiglierò di usare il riscaldamento software: tutto il codice e gli esempi sono forniti a scopo puramente informativo.
Tutti gli articoli