
In uno dei progetti (uno strategico storico 4X) è saltato fuori il compito di spostare parte della logica su altri thread, passando loro uno snapshot dello stato di gioco: così, mentre il thread principale calcola il suo tick, gli altri (AI, pathfinding, UI e così via) possono far girare la propria logica, tipo «chi si trova in questa location», senza lock e senza il rischio di vedere a metà la scrittura di qualcun altro. Per realizzare un sistema del genere bisogna inventarsi come ottenere un indice inverso dei reggimenti per location, e renderne la ricerca economica per i thread: in pratica ogni thread deve avere il proprio snapshot dello stato di una certa parte del mondo di gioco, fotografato al momento in cui parte l'update (frame, tick della logica, giorno, mese ecc.)
La pratica comune è rendere i dati immutabili per la durata del frame, costruire l'indice necessario una sola volta all'inizio e poi lasciare che i lettori ci lavorino sopra. Insomma, dai ragazzi che si occupavano di questo task è arrivato in review un codice del genere (riporto solo la parte principale):
struct Regiment {
    unsigned int location;
    float        health;
    float        mood;
    float        speed;
};

std::vector<Regiment> regiments; // tutti i reggimenti del mondo
std::vector<std::vector<unsigned int>> by_location(location_count);

for (unsigned int r = 0; r < regiment_count; ++r) {
    by_location[regiment_location[r]].push_back(r);
}

... qui facciamo qualcosa con l'array ottenuto
Una struttura del genere (regiments) si chiama jagged array, un array di array (a cosa serve e come lavorarci l'ho mostrato nel libro Game++), oppure, se preferite la terminologia accademica, CSR (compressed sparse row), che è una forma di scrittura leggermente diversa di questi array, o ancora matrici sparse. Strutture del genere sono piuttosto frequenti nei giochi, se avete tante location e vi serve:
- sapere quale loot è sparso in ogni location, quali armate appartengono a ciascuna area;
- oppure quali mostri vivono in una location, quali location fanno parte di un'area, quali aree di una regione;
- oppure controllare i vicini di una location sulla mappa, le adjacency region, su cui si basano il pathfinding e tutto il riempimento delle aree negli strategici globali;
- oppure trovare i nodi nella gerarchia della scena o in uno scheletro;
- cercare le entità per chunk del mondo, i componenti per entità, le entity per archetipo in un ECS;
- trovare i subscriber per tipo di evento, i modificatori attivi per oggetto
- girare tra i vicini di una location e raccogliere metriche
- selezionare i reggimenti per armata / corpo d'armata, per calcolare l'
healthtotale e ilmoodmedio della formazione; - la stessa relazione «proprietario → insieme di entità» per gli edifici in una location, gli ordini sul mercato, i modificatori di una nazione, i vicini sulla mappa, le entity per chunk in un ECS.
- e molto altro ancora...
Ciò che accomuna questi esempi è che le relazioni tra gli elementi sono già presenti nei dati di partenza: non dobbiamo inventarci nuovi collegamenti, ci basta una struttura che permetta di selezionare velocemente un certo insieme. Per esempio, se c'è una lista di armate in cui è scritto dove si trovano, bisogna ottenere rapidamente l'indice inverso delle armate per location o posizione, idealmente con un'operazione a tempo costante che non metta troppo a soqquadro la cache del processore.
Un'altra proprietà implicita: questa struttura la aggiorniamo di rado e la leggiamo moltissime volte. La aggiorniamo al caricamento della mappa, all'inizio del frame o dopo la ricostruzione della scena, e in generale il quando non conta, conta che le fasi di build e di query sono separate. Sembra un vincolo piuttosto rigido, ma guardate la lista qui sopra... lì quasi tutti i dati, in un certo intervallo di tempo, non cambiano posizione all'interno della struttura complessiva, e questo apre la strada a vari trucchi e hack.
L'idea vs la vita reale
E sembra andare tutto bene finché questo array di array è piccolo, ma nel nostro caso d'uso è venuto fuori che, da metà partita in poi, lo snapshot di una struttura del genere costa più di tutto il lavoro per cui lo facevamo. Per esempio, copiare un std::vector<std::vector<unsigned int>> da un milione di location, cioè una copia profonda di un milione di vector, richiede 90 millisecondi (sulla mia macchina; non guardate i numeri in sé, sono indicativi: conta il rapporto tra l'uno e l'altro, non il tempo assoluto). La visita completa della stessa struttura, per cui lo snapshot serve, richiede 14 millisecondi: volevamo parallelizzare 14 ms di lavoro e ne abbiamo pagati 90 solo per cominciare. Per i test ho preso un milione di elementi nell'array esterno e sei milioni di elementi in totale in quelli interni, quindi in media sei per lista, che in realtà è poco: tanto si accumula complessivamente nei vari sistemi verso metà sessione in qualcosa tipo Victoria3/EU4.
Vediamo cosa abbiamo pagato. Il solo array esterno std::vector su un sistema a 64 bit occupa 24 byte (tre puntatori, oppure un puntatore più due dimensioni), e un milione di elementi occupa 24 megabyte solo di impalcatura di servizio, prima ancora dei dati veri e propri; per giunta questi 24 byte si pagano per ogni location, comprese quelle vuote. E se le unità stanno nel cinque percento delle location della mappa, il restante 95% occupa onestamente i suoi 24 byte ma, cosa peggiore, occupa anche spazio in cache quando attraversate questo array di array.
Un'altra proprietà implicita che spesso si trascura è la riserva (capacity): il blocco di memoria reale di un vector cresce più in fretta della dimensione effettiva del vector, e i nostri 6 elementi in realtà occupano otto «volumi» di dati.
E non è finita: bisogna ricordarsi dei metadati dell'allocatore e dell'arrotondamento dei blocchi, che ci sono nascosti ma occupano comunque spazio nell'heap; in glibc l'header del chunk più l'allineamento trasformano una richiesta di 32 byte in un blocco da 48, quindi per dati che sono appena 24 byte ne spendiamo 48.
Ma non è ancora tutto: per arrivare a capacity 8 il vector alloca quattro volte, e per tre volte copia quello che ha già accumulato, quindi per costruire un milione di liste avremo circa quattro milioni di malloc e tre milioni di free. D'accordo, questo non riguarda più la memoria ed è tutto spalmato sui frame, ma è tempo puro che siamo costretti a togliere al gioco; io la chiamo performance «spalmata», nel senso che abbiamo «spalmato» il nostro tempo di frame su tanti piccoli punti. In totale per elemento otteniamo (~circa): 24 byte per il vector esterno, 48 byte per il blocco nell'heap, e settantadue byte per conservarne ventiquattro.
Schema ingenuo, un milione di location:
regiments[]                   heap (blocchi sparsi)
+----------------+            +--------------------------+
| ptr size cap   | ---------> | hdr | 7 idx | 2 unused  |  48 byte
+----------------+            +--------------------------+
| ptr size cap   | ---------> | hdr | 4 idx | 2 unused  |  48 byte
+----------------+            +--------------------------+
| ptr size cap   | --> nullptr   (location vuota, ma i 24 byte si pagano)
+----------------+
   24 byte               +          48 byte          = 72 byte per 24 utili
// circa, dipende dalla modalità di build

regiments[]  [ {loc, health, mood, speed}, ... ]   // array denso di entità
Ed ecco il punto importante, quello per cui aveva senso mettere le mani dentro questo codice e sistemare qualcosa nell'array di array: tutta questa matematica dei byte e il discorso sulla dimensione della memoria sono solo una conseguenza, il motivo principale è, di nuovo, la cache. Quando l'update di gioco scorre le location e per ogni reggimento legge mood e speed, il processore per ogni lista fa almeno due accessi per arrivare all'indice: uno in by_location[i], il secondo tramite il puntatore nell'heap, e poi un altro ancora per i dati. Ma il secondo e (soprattutto) il terzo salto saranno quasi sicuramente un miss, e la CPU dovrà fermare il lavoro per andare in L2/L3 o addirittura in RAM, perché i blocchi sono sparsi alla rinfusa (magari in mezzo ad allocazioni di altri sottosistemi del gioco), e mentre il processore aspetta la risposta dalla memoria non fa nulla: questi cicli a vuoto si trasformano in cali di frame rate quando «avete appena un milione di oggetti».
Misurazioni, per avere un termine di paragone
Nel resto del testo tornerò al primo benchmark (un milione di location, sei milioni di strutture, distribuzione casuale sulle location con coda lunga, x86-64, MSVC 19.4 in release). Coda lunga significa che una parte dei vostri dati esce dalla cache e bisogna andarli a prendere in RAM. Si misurano separatamente:
- build — costruire da zero l'indice location → entità;
- query — scorrere tutte le liste nell'ordine delle location (leggendo
health/mood/speed) ed eseguirci sopra un po' di logica; - query random — come query, ma le location vengono visitate in ordine casuale (così appare una vera richiesta del gameplay, quando il giocatore fa qualcosa durante la partita);
- snapshot — copia profonda dell'indice per un altro thread (inizio frame, distribuiamo i dati tra i thread);
- teardown — liberare l'indice (di rado, va rimandato a fine frame).
| Variante | Memoria | Allocazioni | Build | Query | Query random | Snapshot | Teardown |
|---|---|---|---|---|---|---|---|
vector<vector<uint>> | 63.1 MB | 3.42M | 1045 ms | 14.5 ms | 96.8 ms | 96.7 ms | 61.8 ms |
Perché così tante allocazioni? Perché non conosciamo in anticipo la lunghezza di ogni lista, e da qui arrivano la crescita della capacity, la catena di riallocazioni e la riserva nel buffer.
Primo hack
Ma nessuno ci impedisce di chiedere a ogni entità la sua location: i dati ci sono già, basta passarci sopra una volta in più e contare, quindi...
struct RegimentList {
    unsigned int count   = 0;
    unsigned int written = 0;
    unsigned int* data   = nullptr;
};

std::vector<RegimentList> by_location(location_count);

// passata 1: quanti reggimenti in ogni location
for (unsigned int r = 0; r < regiment_count; ++r)
    by_location[regiments[r].location].count++;

// passata 2: allocare esattamente quanto serve
for (unsigned int i = 0; i < location_count; ++i)
    if (by_location[i].count > 0)
        by_location[i].data = new unsigned int[by_location[i].count];

// passata 3: distribuire gli indici
for (unsigned int r = 0; r < regiment_count; ++r) {
    RegimentList& list = by_location[regiments[r].location];
    list.data[list.written] = r;
    list.written++;
}
Sì, ora le passate sono tre invece di una, ma il tempo speso è diminuito, perché le passate in più su un array denso costano poco, mentre i tre milioni di riallocazioni risparmiati costano parecchio. Questo, tra l'altro, è il copione tipico delle ottimizzazioni di questo genere: una passata lineare sulla memoria è quasi gratis rispetto a qualunque lavoro sull'heap.
Già che c'eravamo, abbiamo buttato via std::vector dalle liste interne e non ci servono più size e capacity: la lunghezza la conosciamo già, e la lista non crescerà più fino al prossimo update. Resta solo una struttura da 16 byte invece di 24 e un blocco nell'heap per ogni lista non vuota.
Due parole a parte sulla tentazione di sostituire tutto questo con un reserve() con un numero a occhio. Non funziona: se indovinate troppo poco tornate alle riallocazioni, se indovinate troppo pagate in memoria per tutto il milione di liste in un colpo; qui invece non tiriamo a indovinare, calcoliamo quanto avremo in memoria e distribuiamo i dati. Vediamo cosa è venuto fuori dopo questo trucco:
| Variante | Memoria | Allocazioni | Build | Query | Query random | Snapshot | Teardown |
|---|---|---|---|---|---|---|---|
vector<vector<uint>> | 63.1 MB | 3 409 088 | 1045 ms | 14.5 ms | 96.8 ms | 96.7 ms | 61.8 ms |
| Contare, poi allocare | 46.7 MB | 650 599 | 153 ms (‑x6.6) | 13.7 ms (‑x1.10) | 40.8 ms | 44.0 ms | 28.0 ms |
Ed è venuto fuori qualcosa di molto interessante: abbiamo accelerato il build e la memoria è scesa di una volta e mezza, mentre la query è rimasta quasi uguale, il che è logico, visto che facciamo ancora due salti in memoria per lista prima di arrivare a regiments[id].mood. In compenso è migliorato il tempo della selezione casuale, perché i dati stanno più compatti e ne entrano di più in cache.
Secondo hack
Avete notato che ogni lista continua comunque a vivere nella sua allocazione? I vector li abbiamo tolti, ma le allocazioni in sé non sono sparite, quindi sono rimasti i metadati dell'heap, la dispersione in memoria e la necessità di portarsi dietro in ogni record un puntatore da 8 byte.
Se al primo passo abbiamo calcolato le dimensioni, perché non allocare anche un unico grande buffer per tutte le liste e disporle lì una dopo l'altra? Così avremo una sola allocazione e le liste disposte per offset: il puntatore non serve più, basta un offset, e se non allocate oltre i 4 GB l'offset vive benissimo in 32 bit. Come vedete abbiamo appena 48 MB di dati, quindi ci va benissimo.
Per risolvere questo problema non serve quasi codice nuovo: nella variante precedente avevamo già dovuto introdurre un offset per ogni lista, per sapere in quale slot scrivere l'elemento successivo. L'unica differenza è che ora l'offset non parte da zero, ma dalla somma delle lunghezze di tutte le liste precedenti: è un trucco noto e si chiama somma prefissa (prefix sum).
struct RegimentList {
    unsigned int count  = 0;
    unsigned int offset = 0;
};

std::vector<RegimentList> by_location(location_count);
for (unsigned int r = 0; r < regiment_count; ++r)
    by_location[regiments[r].location].count++;

// somma prefissa: dove inizia la lista di ogni location
unsigned int sum = 0;
for (unsigned int i = 0; i < location_count; ++i) {
    by_location[i].offset = sum;
    sum += by_location[i].count;
}

// una sola allocazione per tutti gli indici
std::vector<unsigned int> data(sum);
for (unsigned int r = 0; r < regiment_count; ++r) {
    RegimentList& list = by_location[regiments[r].location];
    data[list.offset] = r;
    list.offset++;
}

// offset è avanzato della lunghezza della lista, va riportato al suo posto
for (unsigned int i = 0; i < location_count; ++i)
    by_location[i].offset -= by_location[i].count;
Ecco come staranno ora i nostri dati in memoria:
Schema unificato:
regiments[]                  blob[] — un solo buffer per tutto
+---------------+            +---+---+---+---+---+---+---+---+---+---+---+
| cnt=1 off=0   |----------> | 0 |                                       |
+---------------+            +---+---+---+---+---+---+---+---+---+---+---+
| cnt=6 off=1   |--------------->| 1 | 2 | 3 | 4 | 5 | 6 |
+---------------+                +---+---+---+---+---+---+---+---+
| cnt=5 off=7   |--------------------------------------->| 7 | 8 | ...
+---------------+                                        +---+---+
   8 byte            +        24 byte di dati      = 32 byte per 24 utili

// i dati stanno a parte
regiments[]  [ {loc, health, mood, speed}, ... ]
E come va con i tempi:
| Variante | Memoria | Allocazioni | Build | Query | Query random | Snapshot | Teardown |
|---|---|---|---|---|---|---|---|
vector<vector<uint>> | 63.1 MB | 3 409 088 | 1045 ms | 14.5 ms | 96.8 ms | 96.7 ms | 61.8 ms |
| Contare, poi allocare | 46.7 MB | 650 599 | 153 ms (x6.6) | 13.7 ms (x1.10) | 40.8 ms | 44.0 ms | 28.0 ms |
| Un solo buffer, count + offset | 30.5 MB | 2 | 75.6 ms (x15) | 13.2 ms (x1.2) | 31.7 ms | 5.3 ms | 2.2 ms |
Quindici volte... non percento: con un risultato così si può andare dal tech lead o anche a una conferenza, portando fieri la bandiera dell'impresa compiuta. Le allocazioni sono diventate due, una per l'array dei descrittori e una per il buffer degli indici, ma lo snapshot dell'indice ha smesso di essere una copia profonda di un milione di vector ed è diventato due memcpy, con 5 ms invece di 90, e anche la liberazione è diventata due free invece di centinaia di migliaia. La visita casuale è accelerata di circa tre volte rispetto alla prima versione, perché ora le liste di reggimenti vicine stanno compatte in memoria e il prefetcher fa in tempo a portare su i dati che servono per i calcoli. Le entità stesse si possono intanto snapshottare a parte, con una sola copia dell'array denso, oppure anche non snapshottare... l'importante è non finire per indagare su sé stessi :) Salta fuori che la parte costosa era proprio la comoda implementazione del jagged index tramite i container standard, non l'accesso all'array delle entità.
Non pensate che io sia così furbo... come al solito è già stato tutto inventato prima di noi: questo trucco lo usavano già negli anni Ottanta per disporre gli sprite in memoria sul NES con il massimo impacchettamento, perché la memoria era poca e gli sprite tanti :) E lì gli offset erano gli indici degli sprite, quando volevate disegnarne uno sullo schermo.
E già che ci siamo otteniamo una serie di bonus: ora questa struttura si serializza così com'è e si può mettere nel salvataggio senza doverla attraversare, bastano due fwrite, e al caricamento altri due fread, senza nessuna sistemazione dei puntatori dopo la lettura. Inoltre si copia con un semplice memcpy, e se serve uno snapshot della struttura per un altro thread basta copiare due buffer, senza alcuna copia profonda di un milione di vector.
Continuiamo con la lista dei bonus... ora questa struttura può vivere in un linear allocator, e se viene costruita una volta per frame si può metterla interamente in memoria all'inizio del frame, azzerare il puntatore all'inizio del successivo e liberarsi del tutto dei free; inoltre una struttura così ha smesso di rompersi in caso di rilocazione e spostamento: se per caso serve spostarla, gli indici restano validi.
Terzo hack
Questo hack è arrivato dopo sei mesi di utilizzo della nuova struttura nel gioco, quando un collega ha notato che si potevano ottimizzare le lunghezze delle liste. Guardate cosa succede con le lunghezze:
count:   [ 1   7   4   4  5  ]
offset:  [ 0   1   8  12  16 ]
E ora cosa succede nell'array degli offset:
offset:  [ 0   1   8  12  16 ]
   count:  [ 1   7   4   4  ... ]
La lunghezza della lista i è la differenza tra due offset adiacenti: count[i] == offset[i + 1] - offset[i]. Funziona così perché tutte le liste stanno una dopo l'altra in un unico buffer, e la fine di una lista è l'inizio della successiva; quindi il campo lunghezza si può non memorizzare affatto, basta aggiungere in coda all'array degli offset un elemento che punti alla fine dell'ultima lista. Resta un solo array di N + 1 elementi.
// N + 1 elementi: i reggimenti della location i stanno tra offsets[i] e offsets[i + 1]
std::vector<unsigned int> offsets(location_count + 1);

// offsets[0] parte da zero e resta zero
unsigned int* offsets1 = &offsets[1];

// passata 1: contiamo le lunghezze, ma le scriviamo spostate di uno
for (unsigned int r = 0; r < regiment_count; ++r)
    offsets1[regiments[r].location]++;

// passata 2: trasformiamo le lunghezze in offset sul posto
unsigned int sum = 0;
for (unsigned int i = 0; i < location_count; ++i) {
    unsigned int count = offsets1[i];
    offsets1[i] = sum;
    sum += count;
}

// passata 3: distribuiamo gli indici; gli offset arrivano da soli ai valori giusti
std::vector<unsigned int> blob(sum);
for (unsigned int r = 0; r < regiment_count; ++r) {
    const unsigned int location = regiments[r].location;
    blob[offsets1[location]] = r;
    offsets1[location]++;
}

// la quarta passata non serve: offsets1[i] è arrivato esattamente a offsets[i + 1]
E un array così lo attraverseremo in questo modo:
const unsigned int begin = offsets[location];
const unsigned int end   = offsets[location + 1];
for (unsigned int i = begin; i < end; ++i) {
    const Regiment& regiment = regiments[data[i]];
    if (regiment.mood < 0.25f || regiment.health <= 0.0f) {
        continue;
    }
    travel_budget += regiment.speed;
}

Schema finale:
offsets[]  [ 0 | 1 | 8 | 12 | 16 | 21 ]        N + 1 elementi, da 4 byte
             \___/\___/\__/
              loc0 loc1  loc2
blob[]     [ 0 | 1 2 3 4 5 6 7 | 8 9 10 11 12 | ... ]
4 byte + 24 byte di dati = 28 byte per 24 utili| Variante | Memoria | Allocazioni | Build | Query | Query random | Snapshot | Teardown |
|---|---|---|---|---|---|---|---|
vector<vector<uint>> | 63.1 MB | 3 409 088 | 1045 ms | 14.5 ms | 96.8 ms | 96.7 ms | 61.8 ms |
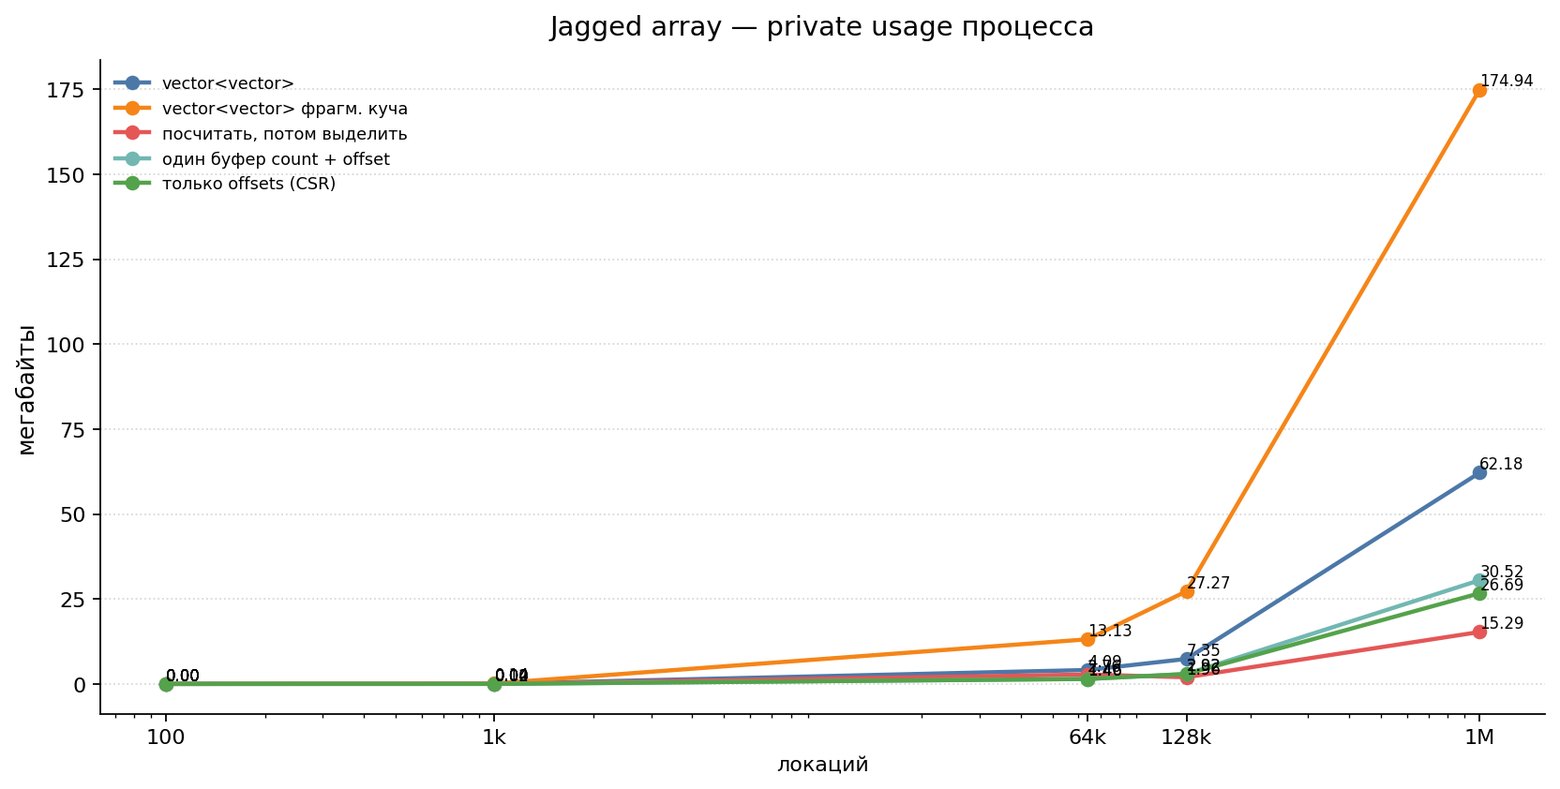
| Idem, heap frammentato | 174.3 MB | 3 409 088 | 1308 ms | 14.9 ms | 95.5 ms | 99.2 ms | 117.3 ms |
| Contare, poi allocare | 46.7 MB | 650 599 | 153 ms | 13.7 ms | 40.8 ms | 44.0 ms | 28.0 ms |
| Un solo buffer, count + offset | 30.5 MB | 2 | 75.6 ms | 13.2 ms | 31.7 ms | 5.3 ms | 2.2 ms |
| Solo offsets (CSR) | 26.7 MB | 2 | 59.9 ms | 12.4 ms | 26.8 ms | 4.2 ms | 1.9 ms |
Togliendo appena quattro byte per elemento (e quattro megabyte su tutte le entità) abbiamo ottenuto la struttura esattamente come la descrive la letteratura accademica, cioè CSR... e, tra le altre cose, un formato che le librerie di algebra lineare sparsa capiscono. A dire il vero non ci è servito granché, perché Eigen non patchato va circa due volte più lento della nostra matematica fatta in casa, ma di questo parleremo un'altra volta...
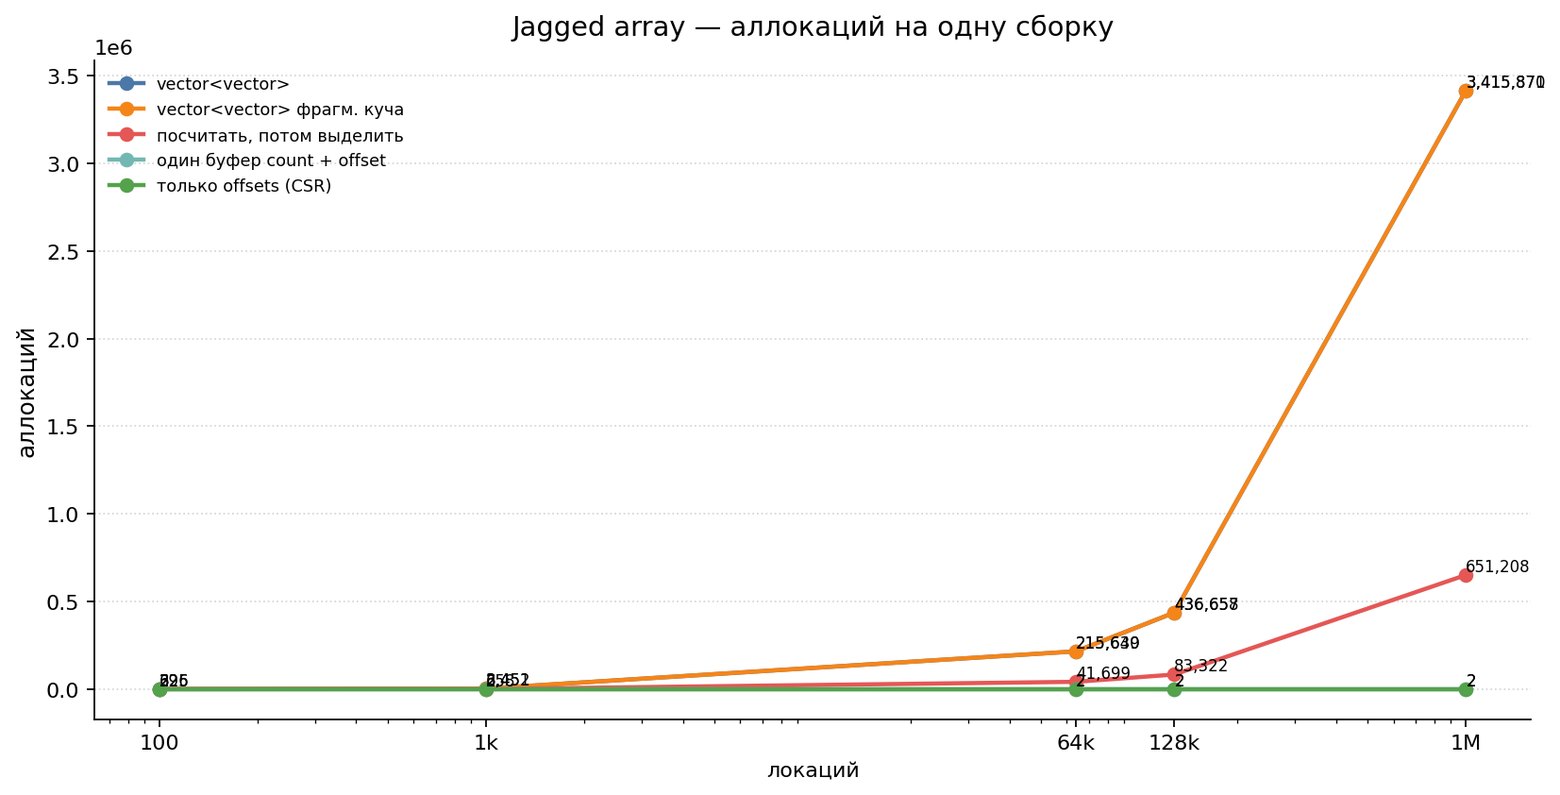
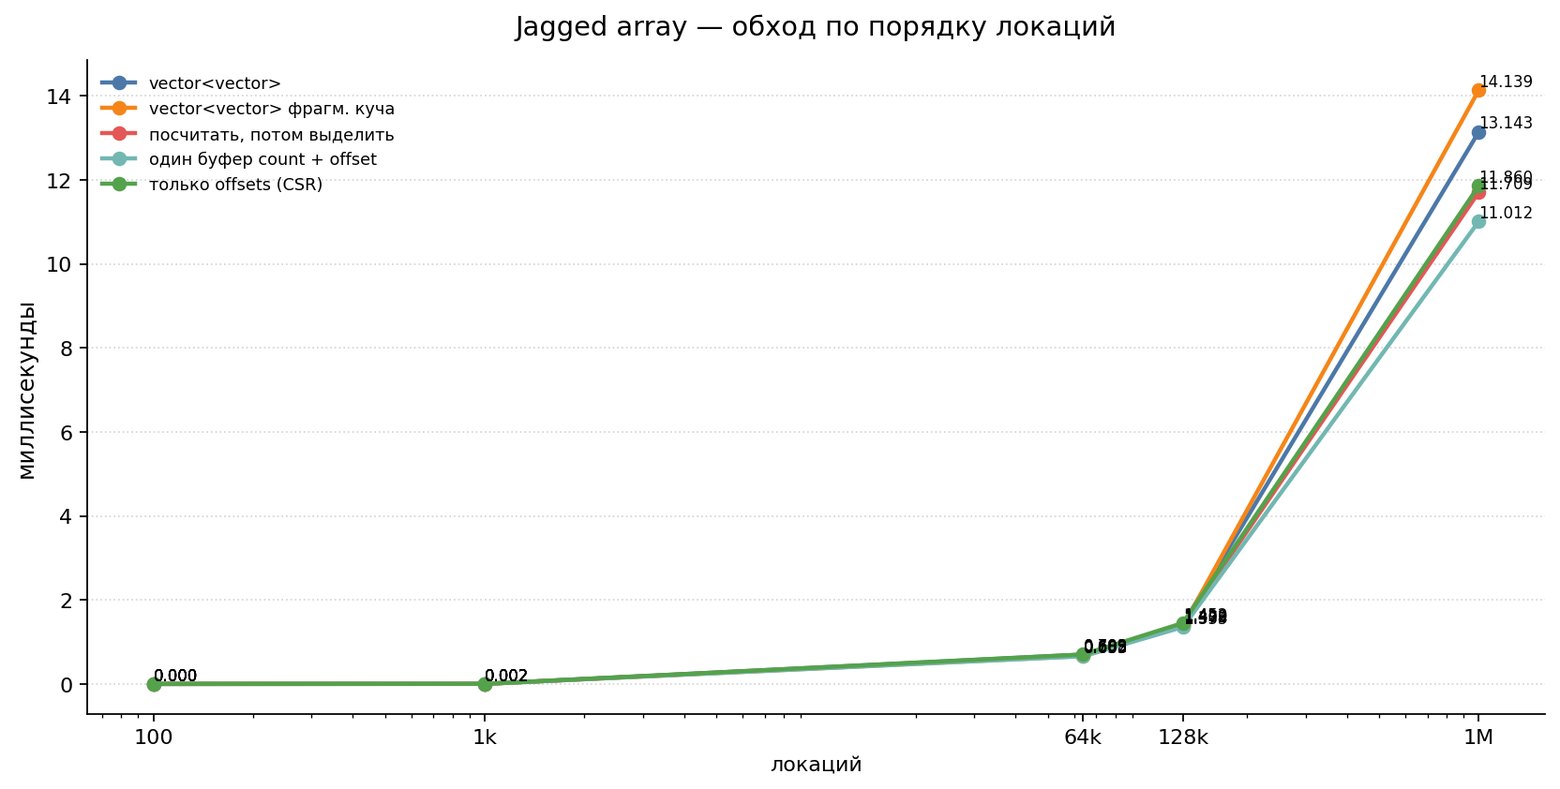
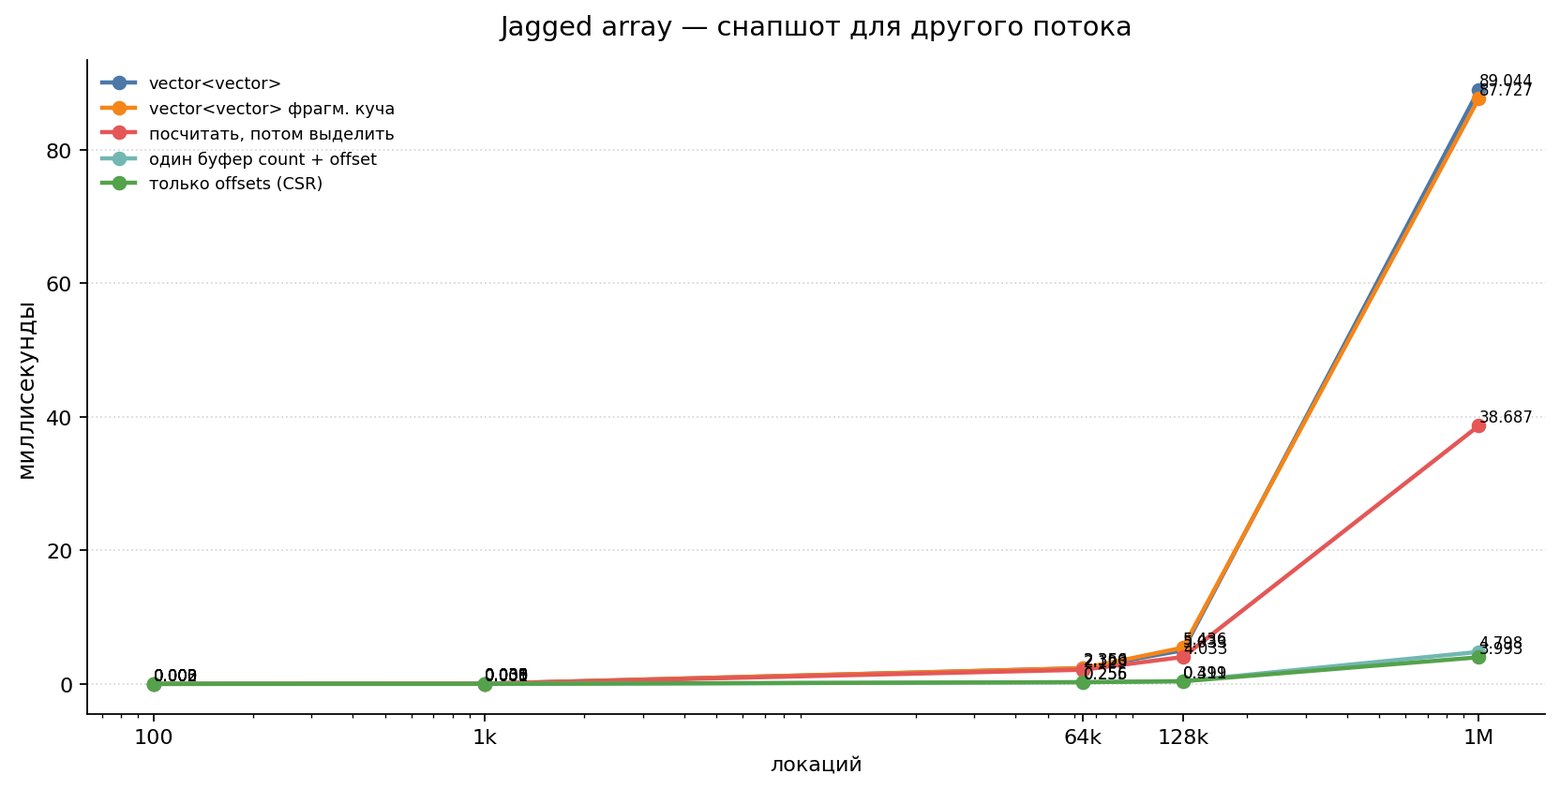
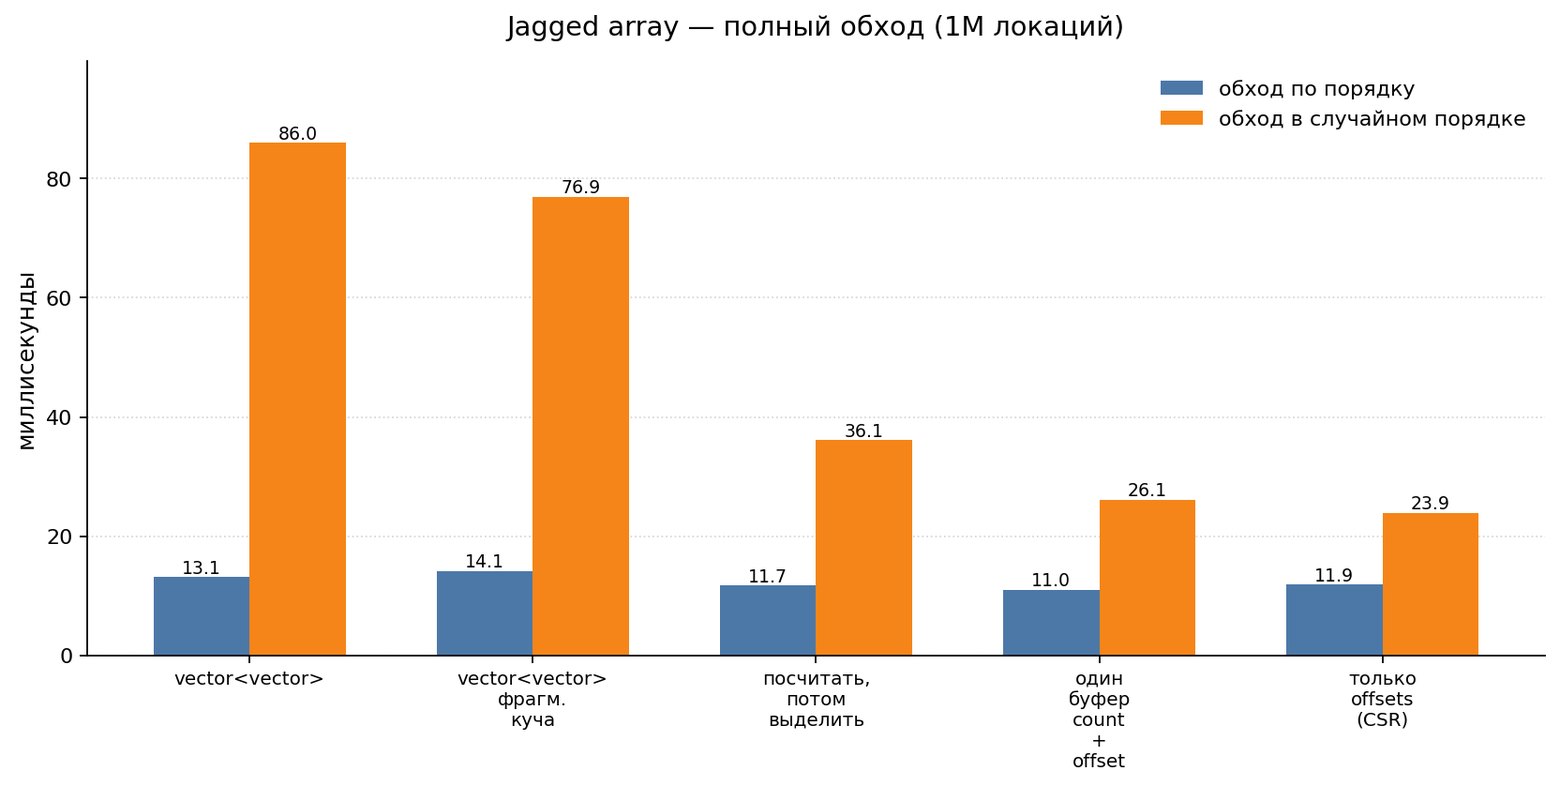
Su dimensioni piccole (100 e 1k) tutte le varianti sono quasi indistinguibili, perché i dati stanno interamente in cache; il distacco compare intorno a 64k-128k e diventa piuttosto grande quando si arriva al milione di oggetti.
Rispetto alla prima variante, con l'ultima il build è 17 volte più veloce, lo snapshot 23 volte, la liberazione 32 volte, la visita casuale 3.6 volte, la memoria è 2.4 volte di meno e le allocazioni sono due invece di tre milioni e mezzo.
Perché nel codice reale il guadagno sarà ancora maggiore
Avete notato la riga con l'heap frammentato? Succede quando, mentre costruiamo il nostro array di array, un altro sottosistema del gioco fa in tempo ad allocare i suoi blocchi in mezzo ai nostri array, cosa che in un gioco grande capita nel 99% dei casi; poi metà di quei blocchi resta sotto forma di buchi, e invece di 63 MB in un blocco di memoria più o meno contiguo otteniamo un'area tre volte più grande con i blocchi sparpagliati qua e là. Questo si riflette sul costo dell'intero algoritmo: una frammentazione del genere colpisce sia la velocità di lettura sia il costo dell'intero ciclo di vita.
Nella versione ingenua arrivata in review, per ogni lista il processore fa due accessi alla memoria distinti, e questi accessi sono dipendenti l'uno dall'altro, quindi il prefetcher non li vede comunque. Una cache line è di appena 64 byte e ci stanno o due vector esterni e mezzo, o sedici indici: nello schema ingenuo, per ogni lista chiediamo alla cache almeno due line, di cui usiamo solo 24 byte su 128. Nell'ultima variante invece una sola line di blob[] copre già due o tre liste intere, e offsets[] viene letto in sequenza, così il prefetcher non fa che infilare i blocchi successivi di dati nella cache L1: in pratica guadagniamo perché abbiamo ottimizzato correttamente i dati per la struttura del processore.
Tutto ha un prezzo, e qui si paga con la rigidità di cemento armato di questa struttura. Se le liste vanno modificate in modo arbitrario, un inserimento nel mezzo significa spostare tutto il buffer: non è una struttura per dati dinamici, e se la vostra lista cambia un elemento alla volta in risposta agli eventi di gioco, meglio tenersi il vector di vector. Ma molto spesso si riesce a riformulare il problema in modo da ricostruire l'indice per intero una volta sola (per frame, per esempio), e si scopre che ricostruire da zero un milione di elementi costa meno che tenersi un vector di vector.
Perché un milione
Negli strategici globali come Civilization, Stellaris, Victoria, Humankind non ci saranno «un milione di province sulla mappa». La mappa raramente supera le 16 mila location (~12k di terra, ~3k di mare), ma ogni nazione ha il proprio snapshot delle location, e ogni modalità di visualizzazione aggiunge un altro layer, per permettervi di passare rapidamente dalla vista generale alle foreste, alle strade o alla redditività. E il milione si accumula come somma degli oggetti vivi della simulazione, non come dimensione di un singolo array locations[].
L'indice esterno serve per tutto ciò che «sta sul terreno»: edifici, reggimenti, modificatori, domanda, controllo; una passata «su tutte le location» di per sé è economica, ma quasi ogni sottosistema si fa il proprio indice inverso o la propria lista per location.
E poi c'è l'economia: ogni tipo di edificio genera a sua volta la sua mappa di location; aggiungeteci città, costruzioni uniche, livelli, mercati, ordini commerciali, domanda/offerta per merce per mercato e per location. Verso fine partita tutto questo diventa migliaia di entità separate, ognuna con il suo health / mood / speed.
E ci sono anche gli oggetti temporanei e derivati, come i modificatori su nazione/location/armata/personaggio, i subscriber agli eventi, i percorsi. Sulla mappa non li vedrete mai, ma in memoria e negli indici ci sono, sotto forma di «proprietario → insieme di entità».
Quindi, nel benchmark, «un milione di slot all'esterno, sei milioni di indici all'interno» non è la dimensione letterale della mappa di uno strategico, ma l'ordine di grandezza del numero di oggetti a cui il gioco arriva verso metà di una partita lunga. Perciò, la prossima volta che aprite il task manager chiedendovi perché il gioco si è preso 24 gigabyte di RAM... non stupitevi, i motivi sono quelli elencati sopra. E poi tutti quei gigabyte bisogna anche riuscire a farli muovere :)
Esisteva già prima dei giochi e degli ECS
È stato inventato molto prima di noi, e nemmeno nel gamedev. Lo schema «conta, somma prefissa, distribuisci» è noto addirittura dalla metà degli anni '50, e l'idea di memorizzare una struttura sparsa come coppia di array «offset più dati» viene dall'algebra lineare della fine degli anni '60, come ho già accennato parlando di CSR e del formato Yale. Noi abbiamo semplicemente «inventato» e applicato ai nostri problemi e alla ricerca per location «un pizzico» di metodi numerici presi dal lavoro con le matrici.
Questa tecnica, che magari vi piacerà e vi porterete nel vostro progetto, in realtà non riguarda affatto i jagged array. Riguarda la separazione dell'operazione in build e query, per poter costruire i dati in una forma radicalmente più adatta alla lettura. Non funziona solo con le liste: così sono fatte le navigation mesh, così funzionano gli archetipi negli ECS, così vivono i vertex buffer, e il risultato è che paghiamo la struttura una volta sola in fase di build, per non pagarla ogni volta in lettura.
Mentre con i colleghi preparavo la presentazione di questa soluzione per il team, mi sono imbattuto nell'articolo Efficient jagged arrays del 2023, in cui l'autore arriva alla stessa disposizione per i vertici di una mesh nel suo progetto. Noi siamo partiti dalle entità di gioco e dallo snapshot tra thread, lui dagli indici dei triangoli, ma alla fine siamo arrivati allo stesso identico schema. Già questo è un buon segnale che il problema si presenta nello sviluppo abbastanza spesso da non doverlo reinventare ogni volta e da meritare una soluzione più riutilizzabile. Purtroppo non ne ho trovata nessuna open source... forse ho cercato male.
Fondamentalmente il problema è rimasto lo stesso degli anni '80 e anche di prima: bisogna che i dati si trovino nel posto giusto, nella forma giusta, nel momento in cui ci passa sopra l'hot path.
← Tutti gli articoli